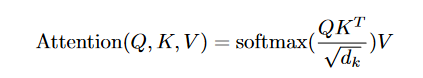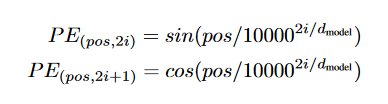<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>Gimdong</title>
  <icon>https://www.gravatar.com/avatar/518b1b47ce716603fc5b5df8c3e9eff1</icon>
  <subtitle>Farewell</subtitle>
  <link href="http://example.com/atom.xml" rel="self"/>
  
  <link href="http://example.com/"/>
  <updated>2022-12-16T12:03:16.126Z</updated>
  <id>http://example.com/</id>
  
  <author>
    <name>Eric Miao</name>
    <email>1838040569@qq.com</email>
  </author>
  
  <generator uri="https://hexo.io/">Hexo</generator>
  
  <entry>
    <title>如何看待目标</title>
    <link href="http://example.com/2022/12/16/water/"/>
    <id>http://example.com/2022/12/16/water/</id>
    <published>2022-12-16T10:00:02.000Z</published>
    <updated>2022-12-16T12:03:16.126Z</updated>
    
    <content type="html"><![CDATA[<h1 id="究竟如何看待目标"><a href="#究竟如何看待目标" class="headerlink" title="究竟如何看待目标"></a>究竟如何看待目标</h1><p><strong>“致虚极，守静笃。万物并作，吾以观其复。夫物芸芸，各复归其根。归根曰静，静曰复命。复命曰常，知常曰明。不知常，妄作，凶；知常，容。容乃公，公乃王，王乃天，天乃道，道乃久，没身不殆。”</strong></p><p>（插一句嘴：这些碎碎念都是饥饿之时所写，或许有许多地方考虑不周，和诸位观点不合，甚至看起来荒唐至极。如果是的话，请各位一定在评论区表达观点，感谢。）</p><p>我个人一直有一个习惯，那就是不论是做什么事情，我都对自己保持着最低的期待。考完试估分，我都会估得比真正成绩低很多；参加比赛，我也一直以“做完就好”、“不后悔就行”去要求自己和队员；参加各种面试评选，也是一直对自己没啥太高的期待。所以会有人觉得我虚伪，也有人说“谦虚过头是炫耀”。听到这些的时候，我总是难以辩解，只能说，你说的对。</p><p>我见识过两种观点：</p><ul><li>一种是：“一直迫切地想要得到什么，最终它都会以某种方式属于你。”</li><li>一种是：“一直迫切地想要得到什么，它只会离你越来越远。”</li></ul><p>显然，我是后者。这并不是我选择的后者，而是我从意识到这件事开始，我才明白我属于后者。于是我开始思考。</p><p>（当然，这两个观点并不代表全貌，只是拎出来进行一些探讨。）</p><h2 id="首先，区别在哪里"><a href="#首先，区别在哪里" class="headerlink" title="首先，区别在哪里"></a>首先，区别在哪里</h2><p>这两种观点，貌似是不可调和，区别明显。</p><p>前者，是坚定地追逐者。为了既定目标，竭尽所能。即使最终没有实现目标，这个过程中也一定有所收获。就好比一项重要的比赛，你迫切地希望捧起奖杯，虽然最终未能如愿，但是你这一路上过关斩将、锻炼起的相关技能素质也都是和你的目的相关的部分，即使你就是差了那一座奖杯。</p><p>而后者呢？后者或许看起来表达的意思是：你迫切地希望捧起奖杯，那你就是拿不到。听起来荒谬至极，对吧？我们都知道，量变带来质变，也知道有志者事竟成，浅显的道理已经被无数人和事证明。</p><p>这么一看，两者简直是矛与盾，水火不容。</p><p>但我说的是，后者并不是完全是表达上看起来的这层意思，这也是我觉得这两种观点最有意思的地方。拿高考举例子吧，两名同学，A和B。A比B要勤奋刻苦，比B对于考上某某大学有着更迫切与强烈的期望，最后因为心态问题与压力导致发挥失常，选择复读。而B一直看起来无所谓的样子，最后一直保持着稳定的成绩直到高考结束，顺利去到了一所还不错的大学。</p><p>这是我瞎编的例子，但是类似的真实故事我相信大家都有听说过些许。从这一点看，第二种观点对人造成的影响是心态上的，与本身的努力无关。现在你会觉得第二种观点更好吗？你不会。因为你也知道，故事的后续有可能是，A复读之后，有了上一次的教训，坚持地付诸努力，最后去到了更好的学校。现在，你是不是觉得第一种观点又胜利了？</p><p>但如果，A在高三的时候依然保持着理想，按照第一种观点去付出努力，又保持着第二种观点去冲淡心里的涟漪，是不是或许又能够在第一次高考，便取得成功呢？这是有可能的。到这里你应该看出来我的意图了，我的意思是，如果用实践的角度去看待观点一，用心理的角度去看待观点二，你会发现它们并不是不可调和的，对吗？</p><p>或许是对的。我迫切地想得到，结果却离我远去，但是这一路上我获得的经验等等属于我自己。这是否是两种观点的一种转化和和解。我认为是的，因为我通篇都在剖析我自己的行事动机，在试图解释我自己。我认为是的。因为我就是这样做的，我抱着最差的预期，去做想做到最好的话应该要做的事情。我以能完全接受事与愿违的心理，我又会以我不能接受事与愿违的意志去实践。</p><p>所以在我看来，这两种观点辩证统一，都是有价值的，并没有太大的区别。</p><h2 id="其次，所以呢？"><a href="#其次，所以呢？" class="headerlink" title="其次，所以呢？"></a>其次，所以呢？</h2><p>所以我说这些干什么？像我先前所言，我想弄明白我的行事逻辑，现在我捋得比较清晰了。接下来，我想探讨：</p><p><strong>如果你不应该把目标看太重，那为什么需要目标，怎么去设置目标？</strong></p><p>目标是肯定需要的，因为你首先得有个“东西”让你去选择看淡或者是看重。所以着重聊聊我怎么去设置目标。</p><p>下面就都是经验之谈与一家之言，大家看个乐呵。</p><p>我们肯定是出于某个目的去做事情，（突然想到康德说的，人是目的而不是纯粹的手段hhh）比如比赛，那么比赛就是一个具体的目的载体；比如考试，那么这场考试就是你的目的。我们通常会选择用一个具体的指标来定目标，因为这个社会就是使用指标来衡量我们的。可以是分数、级别、称号等等等等，这都是惯用的目标手段。但其实，我不会这样去要求自己。因为一旦你选择一个具体的指标作为目标之后，你其实已经在离它远去，已经抱有太强的目的性。</p><p>我会倾向于设置低难度或者抽象的目标。比如考试，我会定义一个：【不挂科】作为起始点，达到这一个点我就完全可以接受。接着，我会往上定一个抽象的目标：【最好是考高一些，尽量别拖后腿】作为第二目标。因为它很抽象，可以避免一种现象：【想考100分却只能考80分】。用这个抽象目标来践行上面的观点一，去做一些实际的努力和实践；用低难度的观点来践行观点二，低难度的目标不会让你迫切，能让你心态上保持平稳。</p><p>总结一下，就是用客观指标制定一个低难度目标；再用一个抽象的话语来概括对自己的一个比较模糊的期待。这样的话，你不仅不容易急躁，还能时时知足。</p><h2 id="最后，扣一下题。"><a href="#最后，扣一下题。" class="headerlink" title="最后，扣一下题。"></a>最后，扣一下题。</h2><p>我是如此制定目标的，这样做有几个好处：</p><ul><li>来自客观指标的压力小</li><li>不容易出现由于压力导致的恶性竞争与无意义内耗出现</li><li>由于期待是抽象的，所以具有弹性空间，容易满足</li><li>如果一切顺利，能到达比设定一个具体高度更高的地步</li></ul><p>当然，坏处也很多：</p><ul><li>第一点就是误解。开头提到的虚伪等等。</li><li>一不小心就容易躺，一定要保持好实际行动与心理预期之间巧妙的制衡</li><li>不可控，由于目标过于抽象，所以对自己的能力层次缺乏清晰量化的认识，这也是目前我最大的问题。</li></ul><p>那我们该如何看待“目标”？</p><p>我不会把目标当作一个要触碰的标杆，我会把它看作山路上的一个个石阶。我不需要目标作为一个逼迫我不断逼近的极限，我希望目标是我不断超越的支点。我享受那种心平气和，顺理成章地成长的安定感。</p><p>或许有一天，我会觉得如果我更迫切一些，我能走的更远，但我不会后悔。因为我知道，这一路上我并没有让任何客观指标来定义我，我过着我自己为我自己定义的人生。</p>]]></content>
    
    
    <summary type="html">请保持平静。</summary>


    <category term="札记" scheme="http://example.com/categories/%E6%9C%AD%E8%AE%B0/"/>
    
    
    <category term="经验" scheme="http://example.com/tags/%E7%BB%8F%E9%AA%8C/"/>
    
  </entry>
  
  <entry>
    <title>康威的生命游戏</title>
    <link href="http://example.com/2022/10/18/Life-game/"/>
    <id>http://example.com/2022/10/18/Life-game/</id>
    <published>2022-10-18T08:39:02.000Z</published>
    <updated>2022-10-19T07:05:08.040Z</updated>
    
    <content type="html"><![CDATA[<h1 id="生命游戏"><a href="#生命游戏" class="headerlink" title="生命游戏"></a>生命游戏</h1><p><strong>康威生命游戏</strong>，前几天看到这个名词，好奇地点进去看了一下。看完之后觉得非常有意思，昨晚自己复现了一下，观察“生命”的流动。同时借此机会，聊一下前面没聊的东西。（源码：<a href="https://github.com/ERICMIAO0817/Conway-s-Game-of-Life">https://github.com/ERICMIAO0817/Conway-s-Game-of-Life</a> 写的并不好，有机会再优化吧。）</p><h2 id="规则"><a href="#规则" class="headerlink" title="规则"></a>规则</h2><p>关于康威生命游戏的规则，在wiki等地方已经有很多解释了，复制粘贴一下：</p><ul><li>每个细胞有两种状态：存活或死亡，每个细胞与以自身为中心的周围<strong>八格</strong>细胞产生互动。</li><li>当前细胞为存活状态时，当周围的存活细胞低于2个时（不包含2个），该细胞变成死亡状态。（模拟生命数量稀少）</li><li>当前细胞为存活状态时，当周围有2个或3个存活细胞时，该细胞保持原样。</li><li>当前细胞为存活状态时，当周围有超过3个存活细胞时，该细胞变成死亡状态。（模拟生命数量过多）</li><li>当前细胞为死亡状态时，当周围有3个存活细胞时，该细胞变成存活状态。（模拟繁殖）</li></ul><p>但这几条“生命规则”，是我对这个游戏产生兴趣的原因。它们似乎道出了几条显而易见的道理：活的拥挤会死亡&#x2F;活的孤独会死亡&#x2F;身处合适的圈子才能存活。正好借此机会，与游戏结合聊聊我如何对待自己，对待他人，对待圈子。</p><h2 id="与自己和解"><a href="#与自己和解" class="headerlink" title="与自己和解"></a>与自己和解</h2><p>在情感问题上，有这样一句话：“爱人先爱己”。也有人说，“爱自己是终身浪漫的开始”。那与之同理，与自己打好关系，才能开始与他人相处。我说，“爱自己是生活的开始”。</p><p>我也时常有厌恶自己的时刻。事实上，我天生自卑，甚至别人夸我的时候，我总是特别心虚，觉得自己不配。所以我不标榜什么“谦虚”这样的借口，仅仅是我不敢认同自己罢了。</p><p>我想，很多人可能觉得我活的很好，为什么会厌恶自己，甚至觉得我是矫情。好吧，也许你是对的。我从来不觉得我的生活有什么很不如意的地方，即使诸事不顺，我也认为自己已经算是很幸运的了。但如果你说我过的轻松、没什么好焦虑的，那很抱歉，我真的每天压力都很大。请在你完全了解一个人之后，再去下定论。这个人也包括<strong>你自己</strong>。</p><p>其实与自己和解，可能并没有那么难。就像你交朋友和维持感情一样，你们要一起做一些彼此感兴趣的事情、给予彼此足够多的信任。我说的“自己”，是指你的心，做你内心感兴趣的事情；给予你内心足够的信任，信任它去和别人敞开心扉，把你的内心当作值得信任的人，不要把它当作你肉体的囚徒，多让它去和别人沟通。</p><p>但我也理解，悦纳自己不简单，敞开心扉更是难上加难。不用着急，我觉得最需要先寻找的，是一个舒缓内心的方式。如果你以前没有和内心沟通的习惯，那么在它闹情绪的时候，往往容易感到不知所措。我的建议是，平时多探索探索安抚内心情绪的方式（比如音乐、运动、睡觉、美食等等），久而久之，你就能掌握与它共处的秘诀。当它开始闹的时候，也不要着急。当你和你的朋友闹别扭的时候，那也经常会持续很长一段时间，学会去适应，一点一点地缩短这个“冷战期”。</p><p>大家喜欢把这种行为称作，找“宣泄口”。但对我来说，这也和处朋友无异，本质上，都是去寻找一个良好的相处模式，真心换真心。我还是更喜欢把内心比作伙伴。</p><h2 id="封装情绪"><a href="#封装情绪" class="headerlink" title="封装情绪"></a>封装情绪</h2><p>这是一个小tip。因为我自己天生有一些“情绪障碍”，具体表现为我会有感触但不会有强烈情绪。所以，我能够在情绪到来的时候依然保持理性的思维，因为情绪根本就占据不了上风，甚至有时候就堵在路上消失了。或许是好事，对吧？不尽然。因为这种障碍，在很多离别时刻，大家都情感泛滥地表达真情实感，我却基本上没有什么波澜，因为我还是理性地看待着这个事情。于是有人说我【无情】，甚至家里人也有说过我太【冷酷】。这是非常难受的，我很想在该享受情绪的时候去享受，去肆意的喜怒哀乐。但我不行，我做不到。我只能将一切感触化作晚上备忘录里的文字，仅此而已。这也使得我会很珍惜极少数情绪泛滥的时刻，因为是很新鲜的体验。</p><p>那这和“封装”有什么关系呢？因为我的这种体质，我能很自然地把情感和情绪一件一件地装在心中的箱子里，不影响到外界。这使得我能和很多曾经发生过不愉快事情的人和睦相处，因为以前事情带来的情绪早就封装起来了，需要的时候再打开就行。这是我这种体质天然做到的，但我觉得这倒不仅限于我这种有障碍的人。</p><p>这一点其实和我的长久以来的观念有关系，我从不去做什么“放下”之类的事情，因为我觉得老让自己“放下”，反而是一次一次加深这件事情在你心中的印象。倒不如直接装起来，慢慢地就在心里被灰尘铺满了。</p><p>所以可以试着，在某次情绪漩涡过后，不要逃避，把它装进箱子里，当作一次经历的纪念品吧。</p><h2 id="与他人共处"><a href="#与他人共处" class="headerlink" title="与他人共处"></a>与他人共处</h2><p>在我关于【管理自己】的博客文章中，有朋友反馈，我并没有在决策中考虑到各个组织&#x2F;事情&#x2F;活动中人际交往的部分。这一点确实是我的纰漏，在这里单独阐述一些我的观点和方式。</p><p>首先，我会漏掉这一点就说明：我并没有在这些事情中受到人际交往的困扰。这也许是一种【幸存者偏差】，但我仔细一想，觉得事情也没有那么简单。从高中以来，我参加了多种多样的事情，结识了五颜六色奇形怪状的人。我也有遇到一些人，他们总是做一些让我不舒服的事情。但事实上，我好像并没有把他们强加在某一个“砝码”中，我并不认为，这些人是与他们隶属的组织强相关的。也和我“封装情绪”有关，我从不因为不愉快的一件事而对一个人一直有看法，因为那件事情会被我装起来，渐渐抛之脑后。但一旦我认定，是因为这个组织&#x2F;事情&#x2F;活动导致这批人让我不舒服了，那么就说明这个事情不是我感兴趣想做的了，这就违背了我决策模型的根基：我想做。</p><p>其次，在康威的生命游戏中，生命周围太拥挤会死、太孤单会死，但合适的圈子能延续生命或复活生命。这也告诉了我们，一昧社交和拒绝社交，都不是好选择。找到适合自己生活的“阈值”，才能好好活下去。以我大学为例。高中的时候，我认识了很多的人，有非常多的好朋友，过得非常快乐开心。但上了大学之后，我突然发现自己变了，我不再喜欢扎堆，我喜欢独来独往，偶尔进行一些社交，我也过的非常快乐开心。起初我以为，这才是真实的我，高中的我只是没发觉这一点而已。现在想想，其实不是。在这场生命游戏中，你会发现一个现象：</p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/output%20(1).gif?versionId=CAEQJRiBgICm9Iu8nxgiIGRjODYwMTg1ZTQ3NDRiMmM5YzFkZjMyMThiNGNjYjhj" alt="动图"></p><p>有一些本身处于稳定结构的生命簇，由于周围环境的变化而被打破。原本一个圈子里的某个生命，被新的簇（如生命游戏里的术语“滑翔机”簇）裹挟着向前，进入了更大的圈子。但也有的生命在巨大的簇中剥离，形成了自己的小圈子。这都是活着，只是因为环境冲击了原本的圈子，在新的环境下，你的圈子可能变小也可能变大，这都和冲击有关。所以一切都是正常的，只要你感到舒适，那么圈子就是适合你的圈子。不要怀疑自己为什么朋友少了，只是因为这个环境下，你的“阈值”就在这里。如果还强行去维持原本的社交水平，那你会很不适应，过得不舒服。</p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/img/Game_of_life_animated_glider.gif?versionId=CAEQJRiBgMC3._.7nxgiIGU4OGU3YmM4ZGY3YzQ1NjNhZDYxMGE1YTRhOWFhNjgz" alt="滑翔机"></p><p>当然，我不是在鼓励“留在舒适圈”，而是在社交这方面，没有必要强迫自己去做些什么。</p><p>还有一点就是，我目前在保持自己“边缘化”。我认为，我目前的社交圈子已经达到了我理想的大小，而每一个组织社团都会更新换代，会有新的人进入扩大圈子（有点像“滑翔机”簇）。在之前隐隐约约感受到有些疲惫之后，我有意地去边缘化自己，尽量保持圈子的稳态。毕竟，一旦突破临界值，我自己可能就会像游戏里的这些生命一样，被裹挟着向前，然后消失在某个时刻。</p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>与自己相处和与他人相处是类似的，无论如何，做你自己，不要变成赝品。</p>]]></content>
    
    
    <summary type="html">很有趣的东西，动手实现一下。</summary>


    <category term="奇怪想法" scheme="http://example.com/categories/%E5%A5%87%E6%80%AA%E6%83%B3%E6%B3%95/"/>
    
    
  </entry>
  
  <entry>
    <title>管好你自己</title>
    <link href="http://example.com/2022/10/10/self-%20management/"/>
    <id>http://example.com/2022/10/10/self-%20management/</id>
    <published>2022-10-10T08:39:02.000Z</published>
    <updated>2022-10-10T09:02:14.061Z</updated>
    
    <content type="html"><![CDATA[<h1 id="管好你自己"><a href="#管好你自己" class="headerlink" title="管好你自己"></a>管好你自己</h1><p>开个大坑，起一个很装的名字。</p><p>这里，我并不希望只是我自己的叙述，我希望大家能在我的分享里面肆意的辱骂、批判我，提出不同的时间管理观点。</p><p>开始。</p><p>在金中的时候，我担任一个组织的会长、一个组织的副团长、一个组织的副部长、一个组织的副部长还是部员来着、一个班的班长，高二的时候，经常东奔西走、制衡天平，尽力做到面面俱到。在我们读高中的时候，金中仍旧处于社团活动的黄金时代，中午1.20才午休、只要不是上课时间都可以进行社团活动。</p><p>先讲一个故事吧，我管理时间的开始。</p><p>记忆犹新的事情是，高一有一天中午，我报名了三大才艺比赛。然后也正好是那一天中午，学生会有事情需要我和另外一个同学去出一个策划案。然后又正好是那一天中午，我的一个部门要召开会议进行工作安排。然后又正好是那一天中午，我的另外一个部门要进行破冰团建。就这样，年少无知的我选择去参加破冰，因为那个部门的人还没见过，感觉第一次不好缺席。</p><p>结果，我忘了给另外一个部门请假，急匆匆地又出了一个策划案，三大才艺还忘记通知我去比赛。倒霉透顶的我，在下午上课前看到桌上的纸条，是另外那个部门晚上约谈我的通知。</p><p>提心吊胆地去了，约谈我的学长学姐听完我的经历之后给了我一些建议，这些建议使得我后来管理时间更加驾轻就熟。第一条建议就是，用一个本子去记录要做的事情；第二条建议，无论如何，提前打招呼总比事后解释花费的成本低。至今，我非常感谢这三位前辈给我的建议，可以说是开启了我管理自己的大门。</p><p>在这件事情之后，我拿了一本本子提前记录明天要做的事情，自此之后，再也没有过类似的情况发生。</p><p>到高二，我就不再需要一个本子来提醒自己，慢慢地能在脑中做一些记录了。也不会再犹犹豫豫，能很快地反应各种事情的优先级，做出一个能接受的决策。就这样，我的高中忙碌又精彩，绝大多数的组织和大家应该都挺喜欢我的（吧···）。</p><p>坏处是什么呢，我对忙碌产生了依赖性。如果没有很多事情的话，我的工作效率真的会提不起来。真是很矛盾的一点，所以我觉得我考研是必定考不上的，因为我不是能一心只做一件事情的人，其实非常可悲。</p><p>话说回大学。</p><p>大学有什么好管理的呢？你或许会问。是的，我也会问，而且我上大学之后明确不想搞什么兴趣社团活动，感觉高中搞的很爽了，大学的社团也有点变味（暴论）。但是几经辗转，我现在的砝码是这样的：</p><ol><li>合唱团</li><li>志愿者</li><li>实验室</li><li>科研</li><li>项目</li><li>绩点</li></ol><p>这是大三开始的情况，大一大二没有科研，换成竞赛。合唱团是我割舍不下的地方，我需要一个场所来歌唱。志愿者是我治愈自己的地方。实验室是我的自习室和娱乐场所、交流场所。科研是大势所趋被迫参与，项目是一心想做好，绩点是必不可少。</p><p>其实说真的，更累了。之前有人问我，怎么做到在成绩、竞赛、科研、项目、生活兴趣中wlb（work life balance），我的核心观点是这样的：</p><ol><li>先找到兴趣。先知道想做什么。这一点能帮助你在各种事情中做出决策。当然，这一点可以替换为功利点的目的，比如哪个投入产出比更高，但我不做这个讨论，因为我是兴趣导向的人。</li><li>不要功利。想获得好结果，就不要想着结果。我参加的比赛不多，但好的结果都是在大一下、大二拿的，因为那个时候很纯粹，就是想试试看，尽力做就行了。有时候你太想争，反而失去了更多。相信我，一个纯粹的队伍在工作效率上一定比一支独裁者领导的队伍要高，因为队伍的总体积极性很重要。哦对，这里强调一个个人观点，任何集体比赛，最重要的都不是比赛，而是人。很多人看不到人的价值，都想着大家一起就是为了好好拿个奖，恕我不能苟同。一个氛围好团队，即使比赛没获奖，到后面依然是你的资源，你们后面一起参加比赛会顺利很多，也会很好沟通。个人观点。</li><li>任何事情&#x2F;组织&#x2F;活动，把握忍耐度与参与度。什么意思？比如你参加了A、B两社团。你在A次次都到，在B隔三差五请假，这不太合适。（前提是你参加的都是你兴趣导向的，参照第一点）所以我一直对每个砝码都持有两个变量：忍耐度、参与度。我会尽量在保证不触碰任何一个砝码忍耐度红线的基础上，做到参与度的雨露均沾。举个例子，合唱团是考勤制度严苛的，忍耐度很低，所以我两年多没缺过一次；而志愿者活动有时候确实有事，也不是不能请假，因为我有同伴和我们一起分担，这个忍耐度就比较高。那怎么权衡呢？是不是觉得如果忍耐度高就等于参与度可以低一点，忍耐度低参与度就可以高一点呢？错！本人观念正相反，对于忍耐度低的事情，尽量下调你的参与度，会给他们形成一种：【看来你是真的很忙，咱们这么严格你也得翘，应该是很大的事情】的感觉；对于忍耐度高的事情，尽量提高你的参与度，会给他们一种：【感觉你确实很忙，但咱们其实没管那么严你还经常来，你一定很看重这个事情】的感觉。 <strong><u>但我再次强调一个大前提：这些事情都是你真心想参与，并且你参与了就要全身心投入！</u></strong> 不然一切决策将顷刻之间失效，所有人都能看出来你并不上心。 <strong><u>我说的一切都基于你要在每个地方都好好地投入，不带一点个人恩怨。只有这样，你才能偶尔做出灵活的权衡决策。这不仅是利己主义，这也是对你参与的组织&#x2F;事情&#x2F;活动的尊重，本身你这么忙还想面面俱到，那么你能做的就是尽力不伤害感情。</u></strong></li><li>最后一条，在三个部分充分运用之后，形成你的决策函数。给每一个砝码配备权重，根据各种事情的变化，包括你自己的兴趣转变，及时地调整权重大小，达到平衡，这是一种艺术。（我的权重来自三个变量：兴趣、忍耐度、参与度，每个人都可以形成自己的，比如加上【收益】【时间成本】等等）</li></ol><p><strong>切勿失其本心，你要做的永远只是你自己。</strong></p><p><strong>再提一个重头。关于绩点。</strong></p><p><strong>这是本人痛心疾首之处啊！</strong></p><p>请各位一定记得两件事情：第一件，人与人的体质是不能一概而论的；第二件，你要做的是学习他人而不是成为他人。刚进入大学，很多前辈和我说，平时抓紧，期末轻松。结果我平时勤勤恳恳，期末一次考了七十几名，一次考了九十几名，哪里出了问题呢？结果我发现，有的前辈说，【大学任何一门学科，都能在三天之内学完考个90分】。这一刻我才意识到，大家都不太一样，大家都有自己学习的节奏。于是我开始总结自己，结合上面提到的，我并不适合一直做一件事情。于是我调整了学习方针，平时“插眼”，期末“拔眼”，成效显著。但我不会讲我具体咋做的计划，因为我希望大家去找自己的节奏。很多时候真的不是你学不会，只是你不太适应大学的模式，不太会学。</p><p>那么，如何在绩点压力下权衡其他事情呢？</p><p>我本来不想讨论这个，因为这起初不是我想考虑的事情。因为以下模型与我的兴趣导向相悖。但现在，我也面临一样的问题，进行一样的探索，在这里斗胆提出以下观点，我目前是按照这些观点重新布局的：</p><ol><li>不再将你的事务权衡看做天平，而是要看做一棵树。树有主干，有枝叶。主干就是到达你终极目标要做的事情（例：保研、出国：绩点，就业：实习以及相应能力培养），在这种架构下去思考，哪些事情离主干近些，哪些事情离主干远些。</li><li>注意顶端效应。生物学上，我们都听说过顶端抑制。在这里，其实有点相似。在某一阶段，你想要促进主干生长，那么你就需要修剪侧芽；在某一阶段，你需要侧芽增产，那么你就要修建主干（全凭印象胡扯，有错误请指正！！）。所以，你要做出牺牲，但是牺牲的是哪个侧芽？就看你的决策了，这里保证了上面的决策函数依然有用，只是不能把主干内容再放进去，要把主干剥离开。</li><li>注重交叉点。事实上，你能在很多事情找到交叉点。比如，竞赛也能达到保研目的，科研也能帮助保研加分。这就是你分枝与主干分叉的地方。请注意这些与主干直接交叉分叉的分支，它们应该在你的决策函数中保持更高的优先级（与其他和主干无关的分支相比）。</li><li>其实上述道理大家都懂，对我来说，问题是怎么与兴趣导向综合呢？其实，对于这种树模型，兴趣更像是根。这棵树不可以没有根。为什么是根？因为根是汲取养分的，你的动力来自于你的根。你如果对你的方向一点兴趣都没有，依然以保研或者科研为主干，迟早枯萎。所以，兴趣在我的模型里依然很重要，我依然在兴趣的驱动下做着修正。</li><li>还有很多小概念，扦插分支、营养补给，但都是fancy的比喻套装罢了，只是感觉用一棵树来比拟，让我的决策更加立体，更加易于理解。</li></ol><p>先写到这里，待本人熬过大三。明年今日，倘若去到想去的地方，一定完完整整补全。</p>]]></content>
    
    
    <summary type="html">如何管理时间，如何面面俱到。</summary>


    <category term="札记" scheme="http://example.com/categories/%E6%9C%AD%E8%AE%B0/"/>
    
    
    <category term="经验" scheme="http://example.com/tags/%E7%BB%8F%E9%AA%8C/"/>
    
  </entry>
  
  <entry>
    <title></title>
    <link href="http://example.com/2022/08/17/birthday/"/>
    <id>http://example.com/2022/08/17/birthday/</id>
    <published>2022-08-16T16:17:37.915Z</published>
    <updated>2022-08-16T17:34:47.362Z</updated>
    
    <content type="html"><![CDATA[<h1 id="关于20岁的我自己。"><a href="#关于20岁的我自己。" class="headerlink" title="关于20岁的我自己。"></a>关于20岁的我自己。</h1><p>20岁了。</p><p>其实没有很多很深刻的感触，或许是生活的重担还没有落到我的肩头，又或许是早已经习惯这种焦虑的生活。</p><h3 id="先聊聊生日。"><a href="#先聊聊生日。" class="headerlink" title="先聊聊生日。"></a>先聊聊生日。</h3><p>我的生日在8月份，也就是暑假期间。而在高考结束前，我一直都是比较难得能出门和朋友聚会的。所以在我18岁以前，我一直觉得，「生日」，就应该是和家人过。但也由于是暑假，爸妈白天也都在上班，我就一个人在家里吃喝玩乐，打打游戏看看手机，逐渐也不觉得有什么新鲜的。</p><p>后来，高三在8月初开学，我人生第一次在学校过了生日。我收到了明信片、信、礼物，我很幸福。那是我直到高中毕业之前最开心的一次生日。我记得那种早晨起床，走向教室的紧张感。说实话，我羡慕了两年，那种社团围圈庆祝、朋友围起来打打闹闹a人，终于也轮到了我。</p><p>在这之后，高考也结束了，我也开始疯狂出门组局，和朋友们肆意地挥霍着时间，浪费着秒钟。</p><p>我会一辈子怀念那种岁月，不用担心前途，不用担心各种校园琐事，不用天天盯着那小数点后两位发愁。</p><h3 id="聊聊自己。"><a href="#聊聊自己。" class="headerlink" title="聊聊自己。"></a>聊聊自己。</h3><p>俯瞰了一下现在的自己，我这样总结：运气好、忽冷忽热、十足理性、偶尔失控。</p><p>运气好是真的，大部分时间我是心怀感恩的。我许多所谓收获都和运气很有关系，成绩、比赛、人缘，都掺杂了运气成分。忽冷忽热，其实是因为我自己关心的事情越来越少，爱分享的事情也不多了，偶尔又会因为朋友或者是一些事情而热起来，比如现在。十足理性，说白了就是冷。我一直有一些情绪障碍，我有感情，但许多时候，这些感情产生不出情绪。我会因为一场全场爆哭的电影而触动，但就是面无表情。我也知道，这是我的阈值比较高，一般的事情触及不到我的灵魂，所以我常常比较理性。偶尔失控，也就是对应的，当事情突然促成某种化学反应，我会很短时间地冲动和失控。</p><p>这就是大致的状态。</p><p>或许我平时的脸比较黑，如果有吓到你的话，不好意思。</p><p>其实我小学的时候，是一个很没用主见的人。基本上就是不敢提出自己意见，不敢说自己想要什么。但有人改变了我。我小学的一任同桌，他学习不好，但是那天他很认真地和我说：“你要有主见，这节课开始，你说什么我做什么！”从小，很多人都和我说过「主见」这个词，我从来没记住。可他这一句话，深深钉在我脑中。是他教会我，敢于说出心声、说出反对意见，也是他教会我，真正值得我欣赏和学习的人，并不是大人口中成绩好的某某某，而是眼神坚定的人。</p><p>初中，对我改变很大的并不是某件事，而是一群人。我很庆幸，在这所学习压力很大的初中里，我遇到的班级同学朋友都是很有意思的人。和他们的这三年，我真正感受到「合群」带来的快乐，那种你一句我一句大家哄堂大笑的感觉真的很美好。那个时候我还不冷，一颗心炽热地流着鲜血。虽然我入学是班里的第一名并且从来没有再考过第一，但是这三年我依然没什么后悔的事情，我认识了到现在还很熟络的朋友们。</p><p>高中，真正养成了我的现在各种性格方面。集体生活+各种活动，让我彻底地远离以前怯懦的自己，让我能够在台上说我想说的，然后享受。但也正是高中各种活动都有所涉猎，让我不得不频繁地做出抉择：时间冲突时，选择谁，放弃谁？久而久之，我在这种不断权衡的过程中慢慢改变，我在选择的面前能做到撇开一切感情因素，做出对自己来说符合逻辑的选择。当时我还没意识到这一点，但这确实是金中赋予我的能力，我也受用至今。</p><p>同样也是在高中，我运气很好，我周围都是最棒的人，做着最有意思的事情。我不是一个好的班长，我没有威严，我没有好点子，但好在我有一帮可爱的同学，把我这个烂泥扶上墙。不管别的班怎么样，我就是坚定地认为我们十三班就是最有凝聚力的班。</p><p>大学，我以为我会很不适应孤独，可恰好相反，我没有一点不适应，甚至很享受。我以为我习惯了一群人打打闹闹，从日出走到日落，后来我才知道，我习惯的不是有这些人陪着我，而是这些人本身。我冷的一面更加泛滥，甚至发展到我能一个月不回什么消息，不关心社交，不关心他人。但好在，也有温暖的人在扶着我。合唱团、寻光、实验室……，我在这些地方都获得了归属感和幸福感，让我不至于彻底冰凉。</p><p>或许也有人觉得我矫揉造作，天天写这些还说自己冷冰冰；有人觉得我把很多事情推给运气就是虚伪；有人觉得我的理性只是一种吹嘘和炫耀。好吧，或许是吧。至少我觉得你说的也有道理。</p><p>但我就是我，看不透的我。</p><p>祝我生日快乐，我常说，不止生日，天天快乐。这句话今天反弹给我自己。</p><p><strong>ps：感谢所有愿意祝我生日快乐的人，今天也欢迎大家和我说一下，我有没有夸下海口但是没有兑现给你的生日礼物或者是其他东西～</strong></p>]]></content>


    <summary type="html">&lt;h1 id=&quot;关于20岁的我自己。&quot;&gt;&lt;a href=&quot;#关于20岁的我自己。&quot; class=&quot;headerlink&quot; title=&quot;关于20岁的我自己。&quot;&gt;&lt;/a&gt;关于20岁的我自己。&lt;/h1&gt;&lt;p&gt;20岁了。&lt;/p&gt;
&lt;p&gt;其实没有很多很深刻的感触，或许是生活的重担还没有落</summary>


  </entry>
  
  <entry>
    <title>First try on Mac</title>
    <link href="http://example.com/2022/07/18/2022-07-18-Macbook%20Air/"/>
    <id>http://example.com/2022/07/18/2022-07-18-Macbook%20Air/</id>
    <published>2022-07-18T13:39:02.000Z</published>
    <updated>2022-07-18T05:11:08.681Z</updated>
    
    <content type="html"><![CDATA[<p>换了台新机器，迁移blog成功。</p>]]></content>
    
    
    <summary type="html">新机器，新起点。</summary>


    <category term="札记" scheme="http://example.com/categories/%E6%9C%AD%E8%AE%B0/"/>
    
    
    <category term="Mac" scheme="http://example.com/tags/Mac/"/>
    
  </entry>
  
  <entry>
    <title>写时复制技术与漏洞调研(COW and DIRTY COW)</title>
    <link href="http://example.com/2022/06/09/cow/"/>
    <id>http://example.com/2022/06/09/cow/</id>
    <published>2022-06-09T13:39:02.000Z</published>
    <updated>2022-07-17T18:11:46.269Z</updated>
    
    <content type="html"><![CDATA[<p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_03.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_03"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_04.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_04"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_05.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_05"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_06.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_06"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_07.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_07"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_08.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_08"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_09.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_09"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_10.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_10"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_11.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_11"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_12.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_12"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_13.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_13"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_14.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_14"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_15.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_15"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_16.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_16"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_17.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_17"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/%E5%86%99%E6%97%B6%E5%A4%8D%E5%88%B6%E6%8A%80%E6%9C%AF%E4%B8%8E%E6%BC%8F%E6%B4%9E--%E8%8B%97%E5%AD%90%E9%98%B3--%E8%AE%A1%E7%A7%912005%E7%8F%AD--8208200907_18.png" alt="写时复制技术与漏洞--苗子阳--计科2005班--8208200907_18"></p>]]></content>
    
    
    <summary type="html">OS课外学习。</summary>


    <category term="技术学习" scheme="http://example.com/categories/%E6%8A%80%E6%9C%AF%E5%AD%A6%E4%B9%A0/"/>
    
    
    <category term="Unix--OS" scheme="http://example.com/tags/Unix-OS/"/>
    
  </entry>
  
  <entry>
    <title>Bert学习记录</title>
    <link href="http://example.com/2022/05/01/BERT/"/>
    <id>http://example.com/2022/05/01/BERT/</id>
    <published>2022-05-01T13:39:02.000Z</published>
    <updated>2022-07-17T18:11:53.877Z</updated>
    
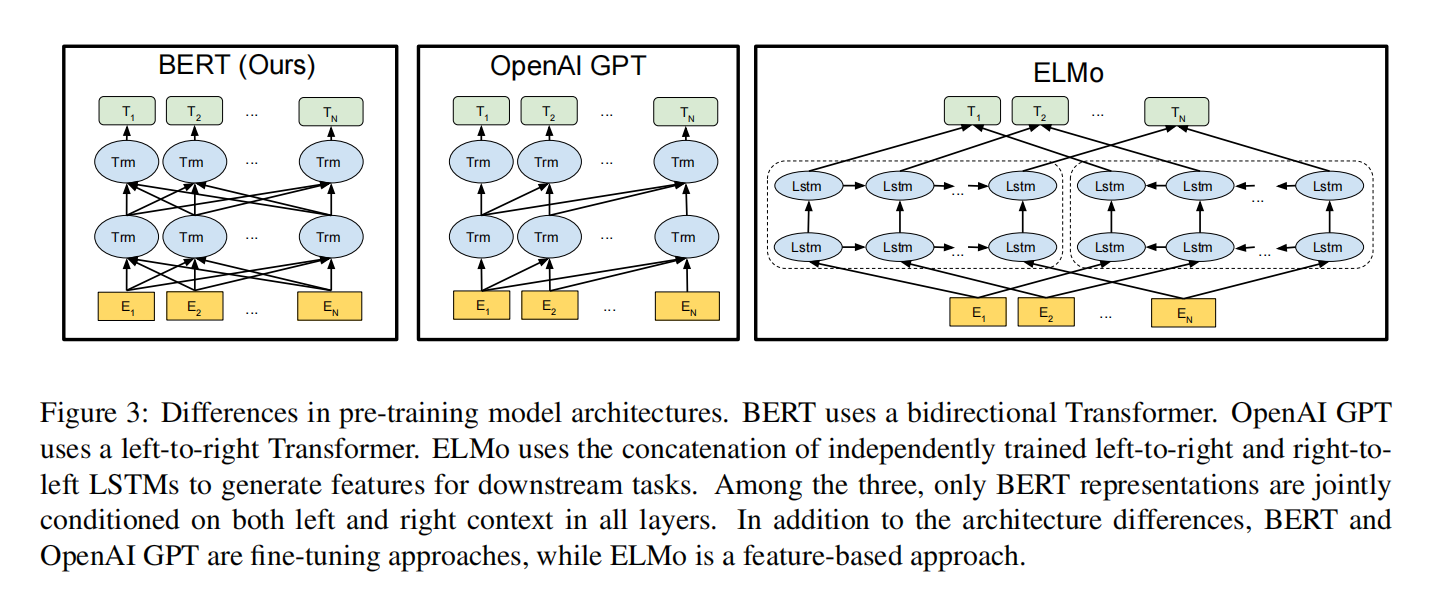
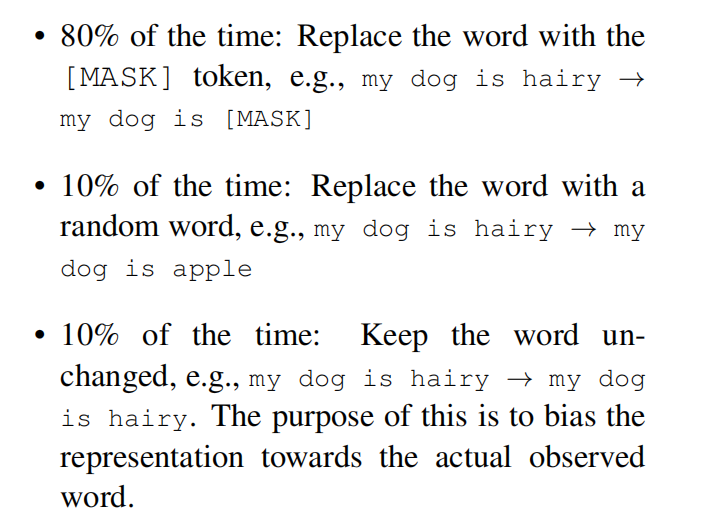
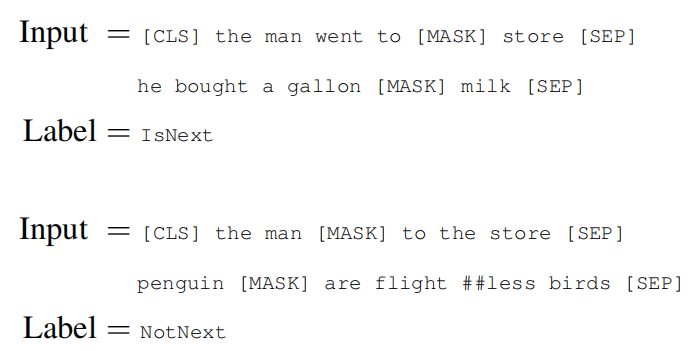
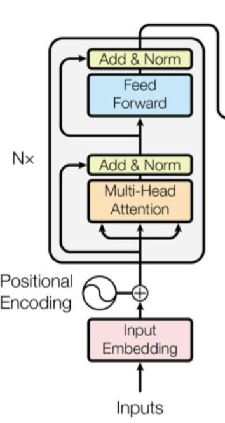
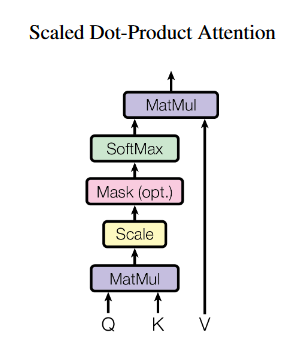
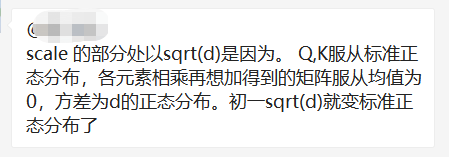
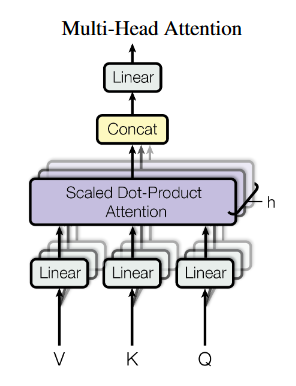
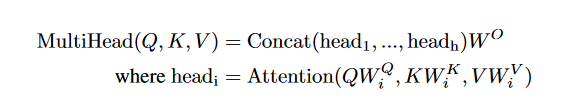
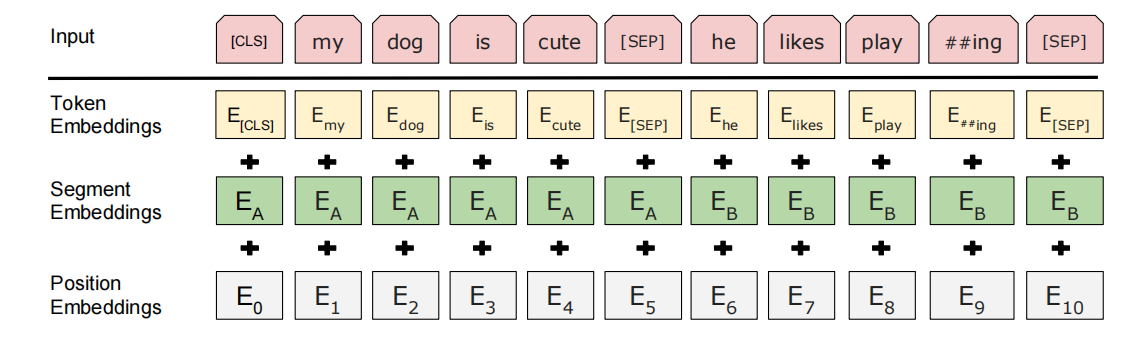
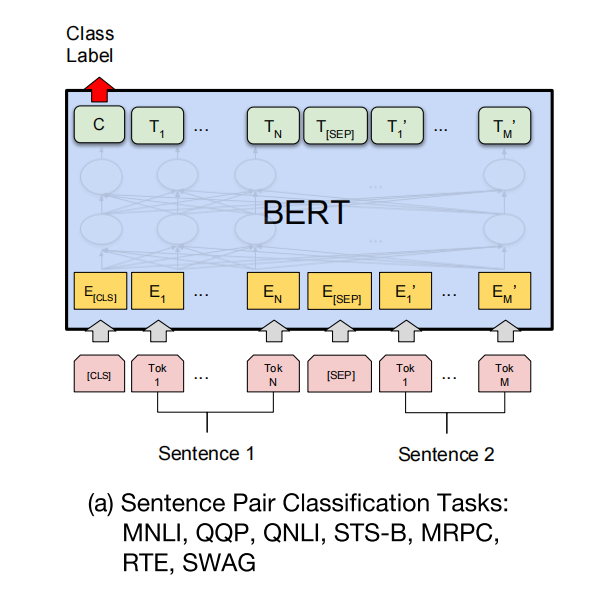
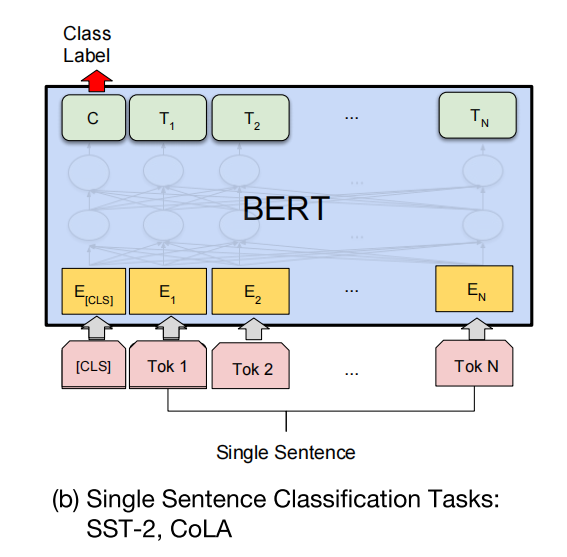
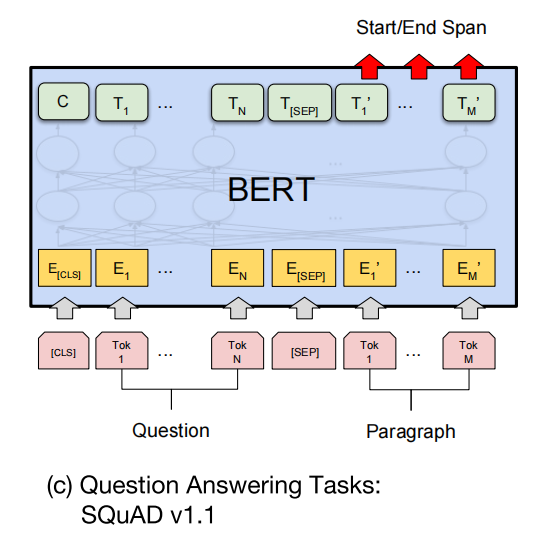
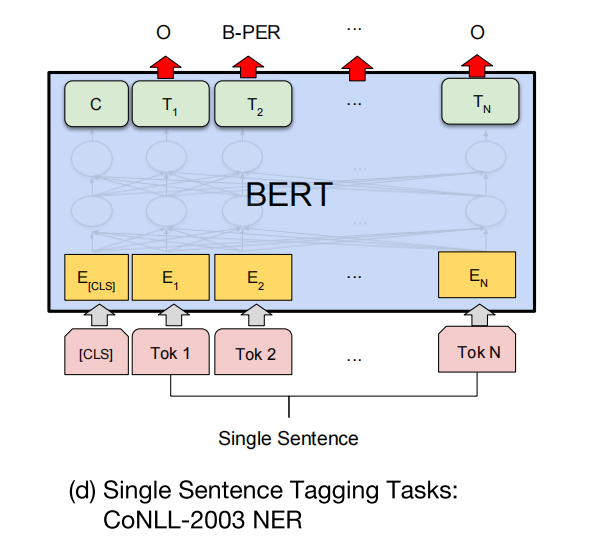
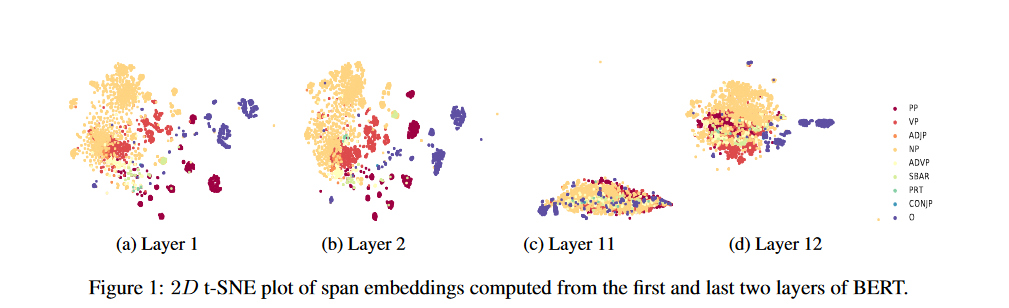
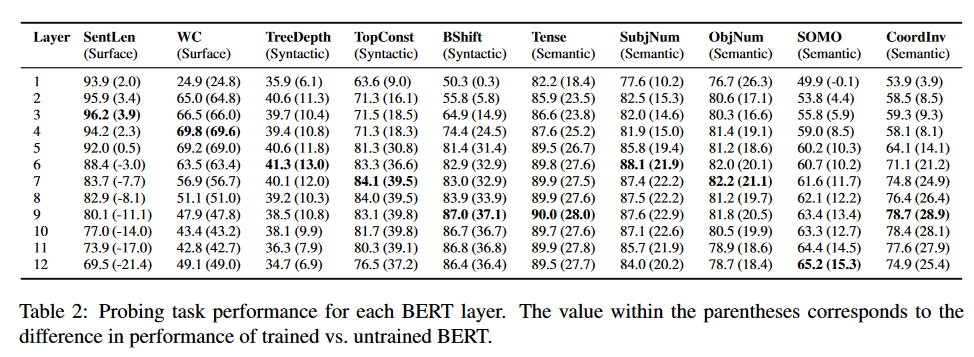
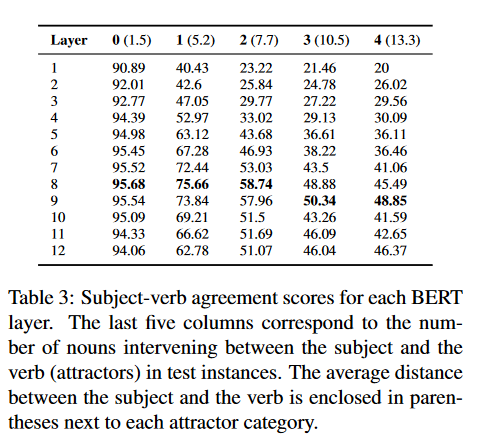
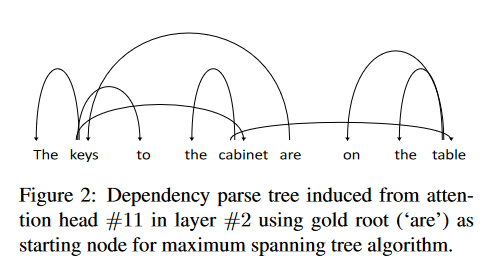
    <content type="html"><![CDATA[<p><em>写在前面：本人刚刚入门NLP，希望通过记录博客来巩固自己的知识，增进对知识的理解。</em></p><p>在之前的博客，我们进行了CRF的原理探寻以及借助CRF工具包实现各类序列标注任务，如中文分词、NER、拼音输入法等等。现在，让我们再上一个台阶，从统计自然语言模型到神经网络自然语言模型。由于最近在进行阅读理解（machine reading comprehension）的学习，因此选择bert这一微调模型的经典之作进行学习记录。现有的Bert可参考的博文也很多，我以个人的视角进行了精华提取，希望能对读者有所帮助。</p><p>Bert论文地址：<a href="https://arxiv.org/abs/1810.04805">https://arxiv.org/abs/1810.04805</a></p><h3 id="Bert是什么？"><a href="#Bert是什么？" class="headerlink" title="Bert是什么？"></a>Bert是什么？</h3><p>Bert，全称为：<strong>B</strong>idirectional <strong>E</strong>ncoder <strong>R</strong>epresentations from <strong>T</strong>ransformers，即双向性Transformer编码器。从它的名字我们可以得知，Bert的要点是：<strong>双向性</strong>+<strong>Transformer Encoder</strong>。接下来，我会围绕这两个要点，分别谈谈我自己的学习心得与看法，仅供参考，希望对你有帮助。</p><h3 id="Bert解决了什么问题？"><a href="#Bert解决了什么问题？" class="headerlink" title="Bert解决了什么问题？"></a>Bert解决了什么问题？</h3><p><strong>先说结论：Bert为NLP任务提供了泛化性强、效果显著的预训练模型。</strong></p><h4 id="什么是预训练？为什么这么重要？"><a href="#什么是预训练？为什么这么重要？" class="headerlink" title="什么是预训练？为什么这么重要？"></a>什么是预训练？为什么这么重要？</h4><p>在CV（图像）领域，有许多预训练模型和对应的预训练权重文件提供给公众使用。这些模型往往是在很大的数据集上（如ImageNet）已经进行了很彻底的训练，我们需要的时候直接对模型进行微调即可。</p><p>预训练与微调的关系就好比说，我现在有一个神经网络，它有50层深。<strong>开始</strong>的时候，我给它的数据集是各种品牌汽车的图片，里面有保时捷、宝马等等并且我也做好了数据集的标注，希望训练出一个能根据车辆图片<strong>识别出汽车品牌</strong>的神经网络。</p><p>训练完成，验证集上也获得了不错的效果后，我被告知：不需要一个能识别品牌的模型，只需要一个能<strong>识别出车型</strong>的模型，比如轿车、SUV、房车等等，但是这个任务的数据集又<strong>很小</strong>。那该怎么办呢？推翻重来？重新训练？其实不需要。你可以把你开始时训练的模型当作<strong>预训练</strong>模型，在上面根据你新的数据集进行<strong>微调</strong>。这样为什么有效呢？</p><p>答案是，神经网络模型的特点决定的这一切有效。在残差引入卷积网络之后，经典的卷积网络都走向<strong>窄而深</strong>的发展方向。在较浅的隐藏层，网络会学到初级的一些特征，比如车的轮廓、大体形状。再深一些的隐藏层，网络会学到更接近任务需求的特征，比如车的流形、车头的长相。对于我们目前遇到的新任务，其实浅层的网络参数不需要再重新学习了，因为车的轮廓和形状对我们很有用，我们直接<strong>冻结</strong>住这些参数。但是高层一些的特征<strong>或许不那么重要</strong>，我们可以对高层网络参数进行<strong>微调</strong>，比如直接重新训练softmax层，或者是重新训练没被冻结的隐藏层等等。</p><p>到这里，你应该明白了为什么预训练模型重要：因为实际生活中的任务很多样，为每个任务重新训练模型成本很高，也不见得有好的效果。</p><h4 id="那NLP为什么到Bert之前，都没有这样的一种体系？"><a href="#那NLP为什么到Bert之前，都没有这样的一种体系？" class="headerlink" title="那NLP为什么到Bert之前，都没有这样的一种体系？"></a>那NLP为什么到Bert之前，都没有这样的一种体系？</h4><p>个人认为，这是因为在NLP领域，Bert出现之前，还尚未有很明确的知识告诉人们，越深的神经网络对自然语言处理也同样越有效，而且NLP的任务比CV复杂许多，图像说到底就是像素点，但是语言任务有处理词的、处理句子的、处理文章的，<strong>最小单位都不大相同</strong>，不同语种之间也有许多的<strong>语言性差异</strong>。但是预训练其实在NLP领域意义重大，因为许多语料数据要进行收集的话，可以很轻松地获得<strong>大体量的无标签数据集</strong>，但是要为各个任务打上标签，那将是很庞大乃至难以想象的工作量。一个好的预训练模型，可以大大提高NLP模型的落地应用转化率。</p><p>其实在Bert之前，也有许多工作在朝着这个方向努力。大体来说，主要是两种策略：</p><p>基于<strong>特征</strong>的预训练（feature-based）VS 基于<strong>微调</strong>的预训练（fine-tune）</p><p>前者的代表作是：<strong>ELMo</strong></p><p>后者的代表作是：<strong>OpenAPI GPT</strong></p><p>两者可以分别理解为：</p><p><strong>feature-based：</strong>基于<strong>网络</strong>的调节，针对预训练得到的输出，还要设计相应的网络来应对不同的task。</p><p><strong>fine-tune：</strong>基于<strong>参数</strong>的调节，针对预训练得到的网络进行网络参数的微调。</p><p>而Bert很明显，应该是属于后者这种接近CV的预训练策略。</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220502200543849.png" alt="image-20220502200543849"></p><p>上图是Bert原文中，与GPT和ELMo做的对比。GPT和ELMo的内容不是本文重点，所以就根据上图进行简要的解释吧。</p><p>ELMo采用的是两个反向的LSTM网络进行训练，试图让两个网络的知识涵盖上下文信息。但实际上，这样直接的将一个从左到右的网络和从右到左的网络进行叠加，并不能在每一层都有效整合上下文信息。对于ELMo而言，主要需求是<strong>获取更多的语言特征</strong>，因此，ELMo的输出其实就是一个Word Embedding，对每个词进行了<strong>特征维度</strong>的扩展。</p><p>GPT采用的是transformer的<strong>解码器</strong>，是一个从左到右的模型。其实Bert和GPT的架构是类似的，都是transformer为基础，只不过Bert采用的是<strong>编码器</strong>，引入了双向性。GPT模型中，每一个词只能根据之前的词是什么来预测下一个词，不能结合下文信息进行预测。</p><p>在Bert之前的预训练模型与策略都有一些绕不开的局限性：<strong>上下文信息难以有效整合、句子层面的任务难以与字词层面的任务在一个预训练模型上相适应。</strong></p><p>而Bert是集大成者，即保留了<strong>微调</strong>的思路，又引入了<strong>上下文信息</strong>，还兼顾了<strong>token</strong>-level与<strong>sentence</strong>-level的任务。</p><p>但是这种双向设计的transformer编码器，其实给Bert<strong>上了一把锁</strong>，具体是什么呢？我们继续往下看。</p><h3 id="双向性（Bidirectional）的体现"><a href="#双向性（Bidirectional）的体现" class="headerlink" title="双向性（Bidirectional）的体现"></a>双向性（Bidirectional）的体现</h3><p>在Bert中，双向性主要由<strong>掩膜语言模型、句子语序预测、自我注意力机制</strong>体现的。</p><h4 id="掩膜语言模型–MLM"><a href="#掩膜语言模型–MLM" class="headerlink" title="掩膜语言模型–MLM"></a>掩膜语言模型–MLM</h4><p>全称，masked language model。其实说白了，就是对输入的句子里面的token进行掩盖（加[mask]），然后让模型<strong>预测</strong>mask掉的词是什么。文中举的例子是这样的：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220502231721222.png" alt="image-20220502231721222"></p><p>值得注意的是，并不是所有的token都会被mask掉，实际上是取输入中15%的token选中进行mask，并且被选中的token也只有80%的几率会被mask，还有10%是替换成别的词，以及10%的概率不mask。</p><p>这样设计的意义是什么呢？</p><p>个人认为，是通过加入了约束规则迫使模型主动地去<strong>学习上下文知识</strong>。如果不给予模型一个任务，很难控制模型的收敛走向。掩膜预测的任务能够帮助模型注重上下文信息，结合这些信息来推断某个token的意思。从这个角度也使得这个token的特征维度得到拓展，不止是token本身，还有上下文中与它相关的知识。</p><h4 id="句子语序预测–NSP"><a href="#句子语序预测–NSP" class="headerlink" title="句子语序预测–NSP"></a>句子语序预测–NSP</h4><p>全称，next sentence prediction。这个任务主要是对输入的句子对是否是顺承关系进行预测，句子对AB的中间以及结尾以[SEP]进行分隔，让模型判断B句子是否是A句子的下一句话。文中举的例子是这样的：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503010256142.png" alt="image-20220503010256142"></p><p>这个任务看起来很简单，也很好理解。后文的消融实验其实证明了它的作用并不显著，但是我认为NSP任务的设计，是为了将模型能更好地从token-level迁移到sentence-level。同时，我也认为MLM和NSP的设计都是为了弥补transformer本身<strong>缺乏序列信息</strong>的特点。</p><p><em>一点补充说明：RNN在<strong>序列信息</strong>的学习其实比起transformer要更加彻底一些，因为transformer会将序列里的每一个token都做自我注意力，导致你的token以任意排列顺序输入都不会有很大影响。所以transformer原本的论文加入了<strong>位置编码</strong>来缓解这一缺陷。</em></p><p>自我注意力机制会放在encoder的部分继续讲述。</p><h3 id="Transformer-Encoder"><a href="#Transformer-Encoder" class="headerlink" title="Transformer Encoder"></a>Transformer Encoder</h3><p>Bert的另一大要点，就是基于transformer的编码器作为网络架构。Bert的基本模型采用了12层编码器堆叠的架构：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503012627364.png" alt="image-20220503012627364"></p><p>上图灰色的矩形内是编码器的基本架构，Bert基本上没有改变transformer的原本设计，直接引用了这个模块。关于编码器，我想，最重要的部分就是：<strong>Multi-Head Attention</strong>。</p><h4 id="什么是Attention？"><a href="#什么是Attention？" class="headerlink" title="什么是Attention？"></a>什么是Attention？</h4><p>顾名思义，是<strong>注意力</strong>。你可以将两个向量之间的距离理解为注意力，离得越近，说明我越注意你；离得越远，说明我不需要怎么关心你。讲到向量，讲到距离，很自然地会联想到点乘，因为<strong>余弦</strong>可以在夹角层面上反应向量之间的距离，或者说，差异性。所以，transformer的原作者采用的就是这种思路来实现注意力：<strong>点乘注意力机制（Dot-Product Attention）</strong>。</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503014818044.png" alt="image-20220503014818044"></p><p>上图是点乘注意力机制的<strong>计算图</strong>。可以看到，基本思路是，将三个输入Q、K、V读入，其中Q与K进行矩阵相乘，进行尺度缩放之后，不掩膜的话就直接softmax得到注意力分数，再将这个分数与V相乘，得到最终结果。数学一点的表示是这样：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503015328447.png" alt="image-20220503015328447"></p><p>是不是<strong>很懵</strong>？没关系，我们一步步来。</p><p>首先让我们明确，什么是Q、K、V。<strong>Q是Query，意为查询；K是Key，意为键；V是Value，意为值。</strong>从编码器的结构也可以看出，Q、K、V的输入其实都是<strong>同一个东西</strong>，比如就是上一个隐藏层的输出。在上面的计算图中，我们实际上是通过Q和K的相乘来获得各个token之间的注意力。在这个过程中，矩阵Q的每一行和转置后的矩阵K的每一列都能做向量相乘，相当于是每一个token都和包括自己的其它token进行了计算。因此，可以将Q视作”查询“，代表我现在<strong>计算到了哪一个token</strong>；而K视作”键“，代表我现在<strong>针对我查询的token进行相对应的各个键的注意力计算</strong>。而V又是什么呢？实际上，Q与K相乘得到的结果，就代表了这段序列内部各个token与每个token之间的<strong>关系信息</strong>，乘以V实际上是将这种关系信息以权重的形式传给原本的输入，让它知道它本身的注意力信息是什么，自己内部的哪些部分联系更紧密、哪些部分关系不大。</p><p>那么，除以${\sqrt{d_{k}}}$又是什么意思呢？这里就是计算图上标题<strong>”scaled“</strong>的体现。原本我认为，除以这个数字单纯是防止对角线上的值过大（因为对角线是某个token和自己相乘，结果是1），把尺度缩小来减轻影响，但是经过学长点拨之后：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503020611362.png" alt="image-20220503020611362"></p><p>发现还有这样更加数学的解释，amazing！</p><p>初步理解attention之后，让我们继续看看什么是”multi-head“。</p><h4 id="什么是”Multi-Head“？"><a href="#什么是”Multi-Head“？" class="headerlink" title="什么是”Multi-Head“？"></a>什么是”Multi-Head“？</h4><p>多头，顾名思义，是在注意力机制的基础之上，多加了好多个”头“。可以简单理解为将上面的计算过程提前分成了好几份分开计算：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503021020604.png" alt="image-20220503021020604"></p><p>上图是多头注意力的模式图解，中间紫色框框内部就是我们刚刚讲到的点乘注意力模块。假设头的数目是h，那么其实就是将Q、K、V分成h份，各自进行点乘注意力。总共就是进行了h次。而且在输入处还能看到，每个头的Q、K、V都乘了一个矩阵（linear）进行映射。数学一点的表示是这样：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503103128972.png" alt="image-20220503103128972"></p><p>可以看到，多头做的事情其实就是将各个attention的结果拼接一下，再乘以一个输出矩阵融合信息。这里值得一提的是：为什么要乘以矩阵呢？其实，主要是因为Bert的训练资料比较丰富，可以拥有更多的可学习空间。如果不乘这个矩阵的话，其实分为多个头和不分多头直接点乘attention的结果没有什么区别。引入这几个矩阵之后，能提供更多的<strong>变化空间</strong>，让模型尽可能学到attention的<strong>多种模式</strong>。</p><p><em>在transformer原作的论文中也提到，这样的方式其实不会对计算量有更大要求，和一次计算完没什么区别。</em></p><p>了解完注意力机制后，让我们来看看Bert的整体<strong>结构</strong>。</p><h3 id="Bert基本结构–预训练"><a href="#Bert基本结构–预训练" class="headerlink" title="Bert基本结构–预训练"></a>Bert基本结构–预训练</h3><h4 id="Bert的三层嵌入"><a href="#Bert的三层嵌入" class="headerlink" title="Bert的三层嵌入"></a>Bert的三层嵌入</h4><p>Bert的结构中，对于输入的token进行了三层嵌入（embedding）：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503114726473.png" alt="image-20220503114726473"></p><ol><li><p>首先是<strong>Token Embedding</strong>：</p><p>这个步骤其实很简单，只是把输入的token乘以一个嵌入矩阵提升维度，为后续嵌入做准备。</p><p><strong>值得一提的是：</strong>输入的token其实是经过了WordPiece的词根词缀字典查找获得的，所以会看到诸如”##ing“这样的形式，表示它不是一个完整的单词。WordPiece的字典大概是3w字量级。</p><p>还有一点是输入的开头，有个[CLS]token，表示输入的开始。每一层编码器的开头都含有这个[CLS]，可以理解为整个block的一个代表，包括最后做分类任务的话，也是以[CLS]作为整个模型的信息融合结果的代表，进行分类。</p></li><li><p>接下来，是<strong>Segment Embedding</strong>：</p><p>这个嵌入部分是与NSP配合使用的，由于需要判断句子对是否有顺承关系，就要先对它们事先进行标记。以”A“代表第一句话，”B“代表第二句话。所以它的嵌入维度是：<strong>2*768</strong>。（图中小细节：第一个[SEP]属于A，第二个[SEP]属于B。）</p></li><li><p>最后，是<strong>Position Embedding</strong>：</p><p>Bert当中的位置编码与transformer中的实现<strong>不同</strong>，transformer原本工作中的位置编码是通过公式计算得到的：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503151315841.png" alt="image-20220503151315841"></p><p>而Bert不同，Bert可学习参数足够多，也需要足够的空间来充分学习语义特征，因此Bert当中的位置编码也是一个<strong>可学习的嵌入</strong>。我们事先给好各个token对应的位置id（不大于512），然后初始化一个<strong>512*768</strong>大小的嵌入。</p></li></ol><p>或许你会奇怪，为什么经常看到<strong>512、768、一对输入</strong>？</p><p>这是由于Bert预训练的初始设置决定的。一开始google预训练的时候，就<strong>设置了输入是一句或者一对句子，最长长度不超过512，隐藏层大小是768。</strong></p><h4 id="直观一些，看看源码"><a href="#直观一些，看看源码" class="headerlink" title="直观一些，看看源码"></a>直观一些，看看源码</h4><p><em>这里使用的是huggingface的pytorch版本Bert，比起TF版本感觉更好看明白一些。详细的讲解可以参考文章：<a href="https://zhuanlan.zhihu.com/p/369012642">https://zhuanlan.zhihu.com/p/369012642</a></em></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">BertEmbeddings</span>(nn.Module):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Construct the embeddings from word, position and token_type embeddings.&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, config</span>):</span><br><span class="line">        <span class="built_in">super</span>().__init__()</span><br><span class="line">        self.word_embeddings = nn.Embedding(config.vocab_size, config.hidden_size, padding_idx=config.pad_token_id)</span><br><span class="line">        self.position_embeddings = nn.Embedding(config.max_position_embeddings, config.hidden_size)</span><br><span class="line">        self.token_type_embeddings = nn.Embedding(config.type_vocab_size, config.hidden_size)</span><br><span class="line"></span><br><span class="line">        <span class="comment"># self.LayerNorm is not snake-cased to stick with TensorFlow model variable name and be able to load</span></span><br><span class="line">        <span class="comment"># any TensorFlow checkpoint file</span></span><br><span class="line">        self.LayerNorm = nn.LayerNorm(config.hidden_size, eps=config.layer_norm_eps)</span><br><span class="line">        self.dropout = nn.Dropout(config.hidden_dropout_prob)</span><br><span class="line">        <span class="comment"># position_ids (1, len position emb) is contiguous in memory and exported when serialized</span></span><br><span class="line">        self.position_embedding_type = <span class="built_in">getattr</span>(config, <span class="string">&quot;position_embedding_type&quot;</span>, <span class="string">&quot;absolute&quot;</span>)</span><br><span class="line">        self.register_buffer(<span class="string">&quot;position_ids&quot;</span>, torch.arange(config.max_position_embeddings).expand((<span class="number">1</span>, -<span class="number">1</span>)))</span><br><span class="line">        <span class="keyword">if</span> version.parse(torch.__version__) &gt; version.parse(<span class="string">&quot;1.6.0&quot;</span>):</span><br><span class="line">            self.register_buffer(</span><br><span class="line">                <span class="string">&quot;token_type_ids&quot;</span>,</span><br><span class="line">                torch.zeros(self.position_ids.size(), dtype=torch.long),</span><br><span class="line">                persistent=<span class="literal">False</span>,</span><br><span class="line">            )</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">forward</span>(<span class="params"></span></span><br><span class="line"><span class="params">        self, input_ids=<span class="literal">None</span>, token_type_ids=<span class="literal">None</span>, position_ids=<span class="literal">None</span>, inputs_embeds=<span class="literal">None</span>, past_key_values_length=<span class="number">0</span></span></span><br><span class="line"><span class="params">    </span>):</span><br><span class="line">        <span class="keyword">if</span> input_ids <span class="keyword">is</span> <span class="keyword">not</span> <span class="literal">None</span>:</span><br><span class="line">            input_shape = input_ids.size()</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            input_shape = inputs_embeds.size()[:-<span class="number">1</span>]</span><br><span class="line"></span><br><span class="line">        seq_length = input_shape[<span class="number">1</span>]</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> position_ids <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">            position_ids = self.position_ids[:, past_key_values_length : seq_length + past_key_values_length]</span><br><span class="line"></span><br><span class="line">        <span class="comment"># Setting the token_type_ids to the registered buffer in constructor where it is all zeros, which usually occurs</span></span><br><span class="line">        <span class="comment"># when its auto-generated, registered buffer helps users when tracing the model without passing token_type_ids, solves</span></span><br><span class="line">        <span class="comment"># issue #5664</span></span><br><span class="line">        <span class="keyword">if</span> token_type_ids <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">            <span class="keyword">if</span> <span class="built_in">hasattr</span>(self, <span class="string">&quot;token_type_ids&quot;</span>):</span><br><span class="line">                buffered_token_type_ids = self.token_type_ids[:, :seq_length]</span><br><span class="line">                buffered_token_type_ids_expanded = buffered_token_type_ids.expand(input_shape[<span class="number">0</span>], seq_length)</span><br><span class="line">                token_type_ids = buffered_token_type_ids_expanded</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                token_type_ids = torch.zeros(input_shape, dtype=torch.long, device=self.position_ids.device)</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> inputs_embeds <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">            inputs_embeds = self.word_embeddings(input_ids)</span><br><span class="line">        token_type_embeddings = self.token_type_embeddings(token_type_ids)</span><br><span class="line"></span><br><span class="line">        embeddings = inputs_embeds + token_type_embeddings</span><br><span class="line">        <span class="keyword">if</span> self.position_embedding_type == <span class="string">&quot;absolute&quot;</span>:</span><br><span class="line">            position_embeddings = self.position_embeddings(position_ids)</span><br><span class="line">            embeddings += position_embeddings</span><br><span class="line">        embeddings = self.LayerNorm(embeddings)</span><br><span class="line">        embeddings = self.dropout(embeddings)</span><br><span class="line">        <span class="keyword">return</span> embeddings</span><br></pre></td></tr></table></figure><p>基本上可以根据代码设计来对照Bert论文给的图片一步步推导。</p><p><strong>值得注意的是：</strong>计算完三种嵌入并将他们相加之后，需要进行<strong>LayerNorm+Dropout</strong>。LayerNorm是transformer原本工作就使用的归一化trick，与BatchNorm不同，LN的方式是在<strong>单个样本</strong>的维度上做归一化，而BN是在整个batch中做<strong>全局</strong>归一化。LN对于NLP任务来说更加合理，因为输入的长短不一，BN的话会出现很多向量长度不同，要补零，影响全局归一化。</p><h3 id="Bert如何微调"><a href="#Bert如何微调" class="headerlink" title="Bert如何微调"></a>Bert如何微调</h3><p>讲完了Bert预训练的几大要点，让我们来看看Bert是怎么进行微调以适应更多task的。</p><h4 id="自然语言推理–NLI"><a href="#自然语言推理–NLI" class="headerlink" title="自然语言推理–NLI"></a>自然语言推理–NLI</h4><p>自然语言推理任务简单来说，就是根据句子对，来推理它们之间的关系，可以视作句子对的分类问题。Bert论文中给出的示意图如下：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503200148095.png" alt="image-20220503200148095"></p><p>其实NLI任务本身就很贴合Bert的设计，与NSP任务也很接近。[CLS]这个class token也正好可以作为分类任务的输出。微调时只需要在[CLS]的输出上面加上一层或几层线性分类器，训练分类器即可。</p><h4 id="单句分类任务–文本分类、情感分析"><a href="#单句分类任务–文本分类、情感分析" class="headerlink" title="单句分类任务–文本分类、情感分析"></a>单句分类任务–文本分类、情感分析</h4><p>与NLI不同，这里的情况是输入不分为上下两部分，但任务依旧是分类任务。示意图：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503201408926.png" alt="image-20220503201408926"></p><p>思路与NLI相同，也是在[CLS]上加线性分类器。</p><h4 id="阅读理解任务–MRC"><a href="#阅读理解任务–MRC" class="headerlink" title="阅读理解任务–MRC"></a>阅读理解任务–MRC</h4><p>阅读理解，machine reading comprehension。阅读理解的任务广度很大，这里主要以QA举例子。也就是我输入一个问题加一篇文章，你要在文章中找到一个部分作为答案。示意图：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503203037531.png" alt="image-20220503203037531"></p><p>那我们是如何利用Bert做QA的呢？其实答案很粗暴，就是文章中对于每个token，分别预测它们作为答案开头和结尾的概率有多高。所以，微调的时候，会对每一个token分别学习两个向量：一个判断它是否作为开头token，一个判断它是否作为结尾token。再加上softmax获得各个token作为开头或者结尾的可能性，取开头中最大概率的和结尾中最大概率的，并将中间内容输出。</p><p><strong>注意</strong>，这里就已经是token-level了。因为你可以看到，我们是对最后一层的所有属于文章的token进行处理，不再只是拿[CLS]作为代表。</p><h4 id="序列标注问题–NER"><a href="#序列标注问题–NER" class="headerlink" title="序列标注问题–NER"></a>序列标注问题–NER</h4><p>序列标注问题就是很典型的token-level的问题，判断每一个token的标签。示意图：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503204132483.png" alt="image-20220503204132483"></p><p>这里其实也很好理解，和QA一样是对每个token的输出做处理。但是不一样的地方在于，QA需要两次计算，算作为开头和结尾的概率。但是NER的话，只用在每个token上加一个类别的分类器来微调即可。</p><p><strong>值得注意的是</strong>：其实这种NER方法依然限制在序列标注本身领域之内，只能对一串句子获得一组标签。但实际上我们知道，像：</p><p><strong>”中国传媒大学“</strong>里面，”中国传媒大学“可以视作<strong>大学</strong>这个命名实体，但是”中国“也是<strong>国家</strong>层面的命名实体。这种交叠的（<strong>nested</strong>）命名实体问题不能用传统思路解决。<a href="https://arxiv.org/pdf/1910.11476v6.pdf">香浓科技的这篇论文</a>提供了一个新思路：<strong>用MRC对NER问题重新建模</strong>，取得了不错的效果。这也会是我接下来的学习方向，后续会更进这篇文章与我自己的想法。</p><h3 id="所以，Bert到底学到了什么"><a href="#所以，Bert到底学到了什么" class="headerlink" title="所以，Bert到底学到了什么"></a>所以，Bert到底学到了什么</h3><p>看到这里，希望你对Bert是什么已经有了一定的了解。那么，让我们回到梦开始的地方，<strong>预训练</strong>。</p><p>上面说，CV中预训练可行的原因是，神经网络窄而深，并且不同的层级有学习到由浅到深不同的特征，这使得微调效果卓著。</p><p>那么Bert做到了吗？Bert各个层是否也学习了<strong>由浅到深</strong>不同层级的语义信息呢？</p><p>怀着这个问题，我看到了这篇文章：<a href="https://hal.inria.fr/hal-02131630/document">What does BERT learn about the structure of language?</a>文章用很多分析手段从多角度研究了这个问题，这里我简要的记录一下。</p><h4 id="短句句法特征"><a href="#短句句法特征" class="headerlink" title="短句句法特征"></a>短句句法特征</h4><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503205437187.png" alt="image-20220503205437187"></p><p>这张图片，原文的意思是大概是说，他们采用了对LSTM相同的研究手段来研究Bert对于短语级别的结构信息的捕捉情况。可以看出，Bert的前两层色块之间有明显的区分，说明Bert能捕捉到<strong>短语级别</strong>的特征信息，但是这些信息在高层（最后两层）消失了，说明低级特征确实没有表现在高层之中。</p><h4 id="三级任务分析"><a href="#三级任务分析" class="headerlink" title="三级任务分析"></a>三级任务分析</h4><p>在这一模块，作者研究了Bert在三大方面信息获取的表现：</p><ol><li><p>表层信息–Surface</p></li><li><p>句法信息–Syntactic</p></li><li><p>语义信息–Semantic</p></li></ol><p>结果如下：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503210403289.png" alt="image-20220503210403289"></p><p>（括号里的内容是和没训练过直接随机初始化的Bert表现的<strong>分差</strong>）</p><p>可以看到，Bert的各个层确实在由浅入深地学习语义信息。</p><h4 id="主谓一致"><a href="#主谓一致" class="headerlink" title="主谓一致"></a>主谓一致</h4><p>这个任务很有意思，个人理解是，在一句话中的主语和动词之间插入更多的名词进行噪声干扰，让模型预测动词的编号是多少。实验结果如下：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503210756744.png" alt="image-20220503210756744"></p><p>可以看出，对于中层的句法任务，插入的<strong>干扰</strong>越多，Bert越依赖<strong>更深层</strong>的网络来解决这个问题，也验证了Bert的网络越深或许在更加复杂的任务上会具有更强的表现。</p><h4 id="注意力机制学到了什么？"><a href="#注意力机制学到了什么？" class="headerlink" title="注意力机制学到了什么？"></a>注意力机制学到了什么？</h4><p>作者通过Tensor Product Decomposition Networks（TPDN）来研究注意力机制的结构，得到了下图的依赖树：</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220503211123026.png" alt="image-20220503211123026"></p><p>可以看出，注意力机制衍生的依赖树证明了Bert学习到了一些语法信息，这些依赖基本上与英语语法相吻合。</p><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><h4 id="贡献"><a href="#贡献" class="headerlink" title="贡献"></a>贡献</h4><p>个人认为Bert最大的贡献莫过于提供了一个可以被广泛应用的预训练模型，极大地推动了NLP领域的落地与应用。而且，Bert还可以迁移到多个语种上进行应用，不只局限于英语。</p><h4 id="局限"><a href="#局限" class="headerlink" title="局限"></a>局限</h4><p>前面埋了一个小彩蛋，说Bert被<strong>上了一把锁</strong>，那么具体是什么呢？其实，Bert的预训练策略导致它天然的不适合做自然语言生成（NLG）任务。因为NLG强调的是，我要根据当前的token和上文所有的一切来预测下一个token是什么，这是<strong>单向</strong>。而Bert的是双向的，它会自然地去结合上下文信息，这就导致它不适合NLG任务，或者机器翻译任务也不合适，因为它并没有使用transformer的<strong>解码器</strong>部分。像GPT采用单向的解码器，就可以适应NLG任务。</p><p>还有一点，是关于<strong>mask</strong>。预训练的时候，输入是有12%（15%*80%）带[mask]的。可是微调与inference的时候，输入是不带[mask]的，这会使得Bert不太适应，不知道怎么去处理，造成一些瓶颈。而且，WordPiece可能是对词根词缀做了mask，但是理论上应该要对整个词进行掩盖才对，这又衍生出了一个改进方向：Bert-WWM<strong>（whole-word-masking）</strong>。</p><p><strong>总之，Bert是里程碑式的工作，也是要理解当下众多自然语言处理模型的基础。所以做了比较详细的记录，特此感谢俊毅哥还有KNLP组中其他的小伙伴们！！</strong></p>]]></content>
    
    
    <summary type="html">参与NLP有关项目，记录学习所得。</summary>


    <category term="技术学习" scheme="http://example.com/categories/%E6%8A%80%E6%9C%AF%E5%AD%A6%E4%B9%A0/"/>
    
    
    <category term="NLP" scheme="http://example.com/tags/NLP/"/>
    
  </entry>
  
  <entry>
    <title>持续更新--金中日子</title>
    <link href="http://example.com/2022/04/07/%E5%9C%A8%E9%87%91%E4%B8%AD%E7%9A%84%E6%97%A5%E5%8D%87%E6%97%A5%E8%90%BD%E3%80%82/"/>
    <id>http://example.com/2022/04/07/%E5%9C%A8%E9%87%91%E4%B8%AD%E7%9A%84%E6%97%A5%E5%8D%87%E6%97%A5%E8%90%BD%E3%80%82/</id>
    <published>2022-04-07T13:39:02.000Z</published>
    <updated>2022-07-17T18:11:53.775Z</updated>
    
    <content type="html"><![CDATA[<h1 id="在金中的日升日落。"><a href="#在金中的日升日落。" class="headerlink" title="在金中的日升日落。"></a>在金中的日升日落。</h1><p><strong>“拜托，如果是金中的话，每一次呼吸都很难忘。”</strong></p><p>这句话来自我昨天收集的问题：“在金中最难忘的日子”，写的真的很好，拿来当开篇了。如果觉得侵权的话，希望你来告诉我你是谁我给你打钱！</p><p>言归正传。今天是Gimdong145岁的生日，按照惯例，是该写点什么。之前有朋友在提问箱中说，想听我高中的故事。那不如借这个机会，盘一盘我的高中三年吧。</p><p>第一次在博客上写小作文，可以多配一些图了。</p><p>大体上按照时间顺序，回忆每个时间阶段的日升日落我在做什么，做一个记录吧。</p><p>也比较意识流吧，请耐心看完。</p><h3 id="高一上-–老十八时期"><a href="#高一上-–老十八时期" class="headerlink" title="高一上 –老十八时期"></a>高一上 –老十八时期</h3><h4 id="日升"><a href="#日升" class="headerlink" title="日升"></a>日升</h4><p>在J栋醒来。往往是起的比较早的，尤其是要<strong>执勤</strong>的话。我也不爱梳头，刷个牙洗个脸就出门了。J栋是在西校区，每次都要走一段路才能到教学楼。</p><p>秋冬和初春偶尔能看到鸡伯放鸡，乌鸡踩在满地的落叶上，发出令人惬意的窸窣声。</p><p>早晨的时候总觉得西校到教学楼的路很长，可能是因为困吧。</p><p>走到教室之后坐下来，思考该干些什么。哦对，还要<strong>早读</strong>啊。我总是会看着自己的桌子发呆，想不起来昨天晚上还有什么作业没写完。</p><p>广播操比赛之后还有早操，每个班前面还有个人负责看谁滥竽充数，记到小本本上。我一直认为没有人会因为广播操而扣很多分，结果总是有人让我<strong>大开眼界</strong>。这里我就不拎出来拿这个人开会了hhh。</p><p>铃响又该吃早餐。如果不是社团部的早餐会的话，我就会和朋友一起去食堂吃饭。特别喜欢鸡米花加白菜，偶尔也会点炒鸡蛋。看着粥里的鸡蛋，我想起了刚到金中的第一天，我也是吃的白粥配炒鸡蛋和肉丝，那个时候我觉得真的人间美味。不过一个月之后就觉得不是很好吃了，可能这就是人吧。</p><p>吃完我会在食堂的小卖部买个燕塘或者什么的喝，夏天更喜欢喝绿豆沙，便宜又祛暑。又是一路jiaolei(方言：嚼舌根)回教学楼。坐下来第一件事就是看桌子上有没有新传来的纸条。有的话，打开自己的小本子记录一下事情的时间地点，以防遗忘(<strong>这是在被社团部学姐约谈后养成的一个习惯，为我后期逐渐成为时间管理大师奠定坚实基础</strong>)。</p><p>跟同桌bb几句，开始上课。</p><p>一般来说第一节课我都稀里糊涂地听过去，老师讲到什么我就能开启无限联想，再回过头来老师已经甩我一条赤道线了。偶尔也会看着窗外发呆，老十八的教室位置很好，外面能看到很多绿叶和小鸟。还记得有一次英语课，三元老师问：<strong>“窗外有什么？”</strong>豪哥抢答：<strong>”Freedom！“</strong>我直接一个爆笑如雷。</p><p>课间也喜欢和17班的朋友们踢毽子，当然了，大部分情况下我都是先飞奔出去传条，再回来挤进毽子大圈里面。偶尔老师也会来一起踢几下，踢的不好还会被我们友好地嘲笑一下。</p><p>大课间也经常冲去办公楼上厕所，还经常遇到熟人(这是可以说的吗？)，因为教学楼一层男厕一层女厕，下楼的时间就已经被占满了。</p><h4 id="午间"><a href="#午间" class="headerlink" title="午间"></a>午间</h4><p>高一的时候很少参与冲食堂的活动，因为我每个中午基本上都有活动要参加，不如直接错峰回宿舍洗个澡，再出来错峰吃个饭或者是在宿舍&#x2F;活动地点啃面包。</p><p>极少数游手好闲的中午，就会去观海平台吹吹风。那个时候金中的休息时间还没发生后面的改革，一点二十之前宿舍都不会关门，也可以趁这个时间回宿舍掏个苹果拿去教室啃。</p><p>那个时候中午经常造访的场所：</p><ol><li><p>活动中心</p><p>社团部有一个日常工作：查各个社团的活动场地情况。其实也就是在各个楼层中间晃悠晃悠，jiaolei一下现在有活动的社团在干什么，看看哪个社团卫生没搞好，哪里风扇和灯没关，很悠闲，感觉自己就像活动中心的保安一样。当时我觉得设施真的不是很好，柜子经常会被白蚁蛀，夏天有的房间特别闷热，学生会的办公室也有点奇怪的霉味。但是不妨碍活动中心经常传来欢声笑语，有时候在wmu的排练室外面会站一会儿，<strong>蹭一下我向往的生活。</strong></p><p>现在在大学，社团都有很不错的资源和发展空间，但是欢声笑语却不再那么的单纯和无忧无虑了。或许是我自己的原因吧，高中的时候，参加社团是因为纯粹地想做一些事，现在大学对我来说，社团活动更像是让我能够逃离每天面对的烦恼，让我喘口气，缓一缓。</p></li><li><p>食堂四楼</p><p>高一的时候我真觉得应该把食堂纳入社团部活动地点范围内，中午特别多在食堂商议大事的社团组织。多少的专场、摆摊、社庆，都是在食堂走出来的。食堂可以吵吵闹闹，也经常听到AP在扒谱。</p></li><li><p>学术报告厅</p><p>当时的学报，主要是参加学生会的定期会议和一些活动。想到固定的学生会开会，就觉得很想念。大家坐在一排，看哪个部门经常被拉出来批评，哪个部门又会获得流动红旗。开完会之后，大家围观某人又坐着睡着了(这是可以说的吗？)。</p><p>那个时候我就觉得学报好高级啊，每个椅子都有配备桌子给我摸鱼–写作业。</p></li></ol><h4 id="午后"><a href="#午后" class="headerlink" title="午后"></a>午后</h4><p>干完正事儿，又晃荡去卜蜂买点吃的喝的，再晃荡回教室。</p><p>差不多两点半上课的时候就开始打瞌睡，迷迷糊糊一睁眼就是三点多下课了。总是想撑到第一节下课再睡觉，但是一下课就精神，困都在第一节课内犯完了。</p><h4 id="日落"><a href="#日落" class="headerlink" title="日落"></a>日落</h4><p>稀里糊涂地又放学了，一般来说这个时间点的正式活动会少一些，排练性质的会更多。</p><p>天气好的时候，晚霞升起，不用出教室就能看得很清楚。日落时的云，以色彩鲜艳者为上。即使教室里面就能看到，还是很多人会趴在栏杆上边聊边看。而且神奇的是，每一层楼的风景都有很大不同。三楼看到的是鲜艳的红色，四楼可能就是偏紫的墨红。</p><p>最好看的晚霞大多出现在晚修马上开始的时候，值日的年级长老师们总是会出来招呼大家进教室准备晚修，<strong>然后自己悄悄拍下今天的晚霞</strong>，囤起来发朋友圈。</p><p>晚修开始，也一样是很愉快的。高一总是游手好闲，晚修也是偷偷聊天，和同桌前后桌，甚至传纸条在全班范围内进行无连接却可靠的网络信息通信。也很喜欢看着一些人发呆，<strong>比如一些连呼吸都很好笑的朋友，只要盯着他五分钟，一定会发生一些让你满载而归的事情。</strong></p><p>挠十五分钟的头之后，开始做一些正事。老十八时期我<strong>晚修的时间分布</strong>大致如下：</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">pie</span><br><span class="line">    title 我晚修在干什么</span><br><span class="line">    &quot;写作业&quot; : 45</span><br><span class="line">    &quot;写方案或者和活动有关的事&quot; : 35</span><br><span class="line">    &quot;闲聊或者发呆&quot; : 20</span><br></pre></td></tr></table></figure><p>是的，高一上真的是这样。</p><h4 id="月升"><a href="#月升" class="headerlink" title="月升"></a>月升</h4><p>晚修大课间，格外热闹。</p><p>冲夜宵的、教室电脑逛B站的、扫雷的、去卜蜂散心的、吃各种水果的、冲来冲去传条的、讨论题目的、踢毽子的、打球的…</p><p>很喜欢没事的时候去教室旁边的篮球场和观海平台走一圈，经常也能听到有人在吹笛。也有很多围圈jiaolei或者是庆生的。我一直认为，晚修课间的金中，是最热闹的。因为有沉寂静谧星空的衬托，显得这片星空下的每个人都更加鲜活。</p><p>没有执勤任务的话，就会在眼保健操的时候假装作为班长在班里巡逻，督促大家做操，<strong>实际上是我自己不想做。</strong></p><p>最后一节晚修过的很快，因为前面15%的时间都在想课间发生的事，后面25%的时间学习一下，剩下的时间上去说一下班里要注意的事情或者是要做的事情，就放学了。</p><p>披星戴月，向西校区进发。</p><p>与日升时相比，这个时候到西校的路总是很短。你一言我一语的，不知不觉就到宿舍门口了。</p><p>我的位置是宿管看不到的，偶尔会拿六分仪(手机)冲一下浪，就睡觉了。</p><p><strong>老十八的时候，最感恩的是每一个包容我的人。我第一次当班长，第一次组织策划活动，第一次感受成长。</strong></p><h3 id="高一下-–十三班时期"><a href="#高一下-–十三班时期" class="headerlink" title="高一下 –十三班时期"></a>高一下 –十三班时期</h3><h4 id="日升-1"><a href="#日升-1" class="headerlink" title="日升"></a>日升</h4><p>还是在西校区，一样的醒来。我经常卡在大家集中醒来的前两分钟醒过来，刷牙前没什么人，刷完牙走廊就都是人了。</p><p>I栋是和隔壁班混住，不知道为什么有时候早上起来之后看到aos的笑容就觉得很安心。</p><p>一样地赶路，去到十三班的教室。那个时候刚刚分班，很多人也不是很熟悉。每次走进课室都刻意地避免一些眼神接触，坐下之后又开始频繁地找话题和前后左右聊天。</p><p>反思一下其实我真的很吵，Elva也说：<strong>”怎么mzy去到哪里哪里都会吵起来啊？“</strong>是啊，或许也是一种超能力吧。</p><p>高一下其实是比高一上认真的，可能是因为分了文理科，不想落下大家太多吧。</p><p>高一下明显比高一上轻车熟路很多，慢慢地也不需要一本本子告诉我今天要干什么了。</p><h4 id="午间-1"><a href="#午间-1" class="headerlink" title="午间"></a>午间</h4><p>与高一上有一点不同，是加入了合唱团。</p><p>所以去学报的次数多了很多，基本上都是排练。自从加入蒲公英之后，活动的重叠程度开始多了起来，慢慢开始锻炼”端水“的能力。</p><p>中午在学报排练也总是很惬意，唱过《大鱼》、《奉献》、《蒲公英》…每个音符都很温暖。事实上每次排练完都很舒服，觉得精神饱满精力充沛，但事实上是一上课就睡着了。甚至有一次我在排练的时候居然也睡着了。</p><p>偶尔也需要准备一些糖果，蒲公英每个月会举行生日会，给这个月生日的团友们庆生。</p><h4 id="午后-1"><a href="#午后-1" class="headerlink" title="午后"></a>午后</h4>]]></content>
    
    
    <summary type="html">参与NLP有关项目，记录学习所得。</summary>


    <category term="金中" scheme="http://example.com/categories/%E9%87%91%E4%B8%AD/"/>
    
    
  </entry>
  
  <entry>
    <title>云翳</title>
    <link href="http://example.com/2022/04/01/%E4%BA%91%E7%BF%B3/"/>
    <id>http://example.com/2022/04/01/%E4%BA%91%E7%BF%B3/</id>
    <published>2022-04-01T13:39:02.000Z</published>
    <updated>2022-07-18T04:09:32.168Z</updated>
    
    <content type="html"><![CDATA[<h1 id="云翳"><a href="#云翳" class="headerlink" title="云翳"></a>云翳</h1><p><strong>“云翳”</strong>一词，第一次见是在高中的文言文练习中。那时我以为，“云翳”，就是指云朵。尔后查阅答案，发现竟然有“眼疾”的意思。从此，“翳”作为“遮掩”之意，深深印在了我的脑海里。</p><p>上周，由于疫情防控，全校转入线上教学。我有一本书逾期未还，晚上赶忙徒步前往图书馆。撑着伞，沿着路灯的微光走在校道上，我突然想到这个词。可能是因为星城顶上汇合的乌云，遮天蔽日，才想到了“云”和“翳”。乌云遮蔽了本属于星城的光芒，也好似一种“眼疾”。</p><p>于是又想到疫情。<strong>肆虐的病毒，剥夺了本该享受阳光的日子，是否也可以近似看作”翳“、看作眼疾，因为它夺走了一些光明？</strong></p><p>怀揣着这些不切实际的思考，不知不觉走到图书馆前。我这才猛然发觉，上次在新校校内走路，好像是很久以前的事了。A座大门开放以后，大家都会选择走<strong>更近的道路</strong>，就算是走新校，我也都是借助交通工具通勤。想到这儿，不再看着脚下，刷卡入馆，开始抬头看向四周。</p><p>我从未见过如此沉寂的图书馆。平日里，图书馆总是灯火通明，奋笔疾书的学生们映射出向上的气息。而今天的图书馆，只有各层楼藏书区域有开着灯，与往日相比，这些书籍显得更加神圣。我快速还书、找寻新的书籍借阅，走出图书馆。回头再看了一眼，与以往亮堂的时候相比，多了几丝<strong>庄严</strong>。</p><p>我略微有些兴奋，想在教学楼走一走。刚踏上B座的走廊，我打了个寒战：我感觉，自己的<strong>每一步都踩在碎玻璃之上，惊扰着这份寂静；我的呼吸不觉放缓、放轻，彷佛这鼻息破坏了静止的空气</strong>。一切，都好似暂停了，除了雨点，一切，都岿然不动。踮着脚尖穿过走廊，我快步离开教学楼，生怕惊扰无数的<strong>睡梦</strong>。</p><p>走回宿舍的路上，回想刚刚的所有。倘若不是这次疫情，我或许很难静下心来，深刻地感受新校的砖、瓦、花、草。或许，这正是一次难得的机会，让平日赶着走”更近道路“的所有人静下心来，倾听雨点、雷声。<strong>疫情或许是一种”翳“，那不如趁此良机，把早已藏在心中浮躁的”云翳“清扫干净罢。</strong></p>]]></content>
    
    
    <summary type="html">一些突如其来的随想。</summary>


    <category term="札记" scheme="http://example.com/categories/%E6%9C%AD%E8%AE%B0/"/>
    
    
    <category term="封校的日子" scheme="http://example.com/tags/%E5%B0%81%E6%A0%A1%E7%9A%84%E6%97%A5%E5%AD%90/"/>
    
  </entry>
  
  <entry>
    <title>使用CRF进行分词训练与推理</title>
    <link href="http://example.com/2022/03/25/%E4%BD%BF%E7%94%A8CRF%E8%BF%9B%E8%A1%8C%E5%88%86%E8%AF%8D%E4%BB%BB%E5%8A%A1/"/>
    <id>http://example.com/2022/03/25/%E4%BD%BF%E7%94%A8CRF%E8%BF%9B%E8%A1%8C%E5%88%86%E8%AF%8D%E4%BB%BB%E5%8A%A1/</id>
    <published>2022-03-25T15:39:02.000Z</published>
    <updated>2022-07-17T18:11:53.820Z</updated>
    
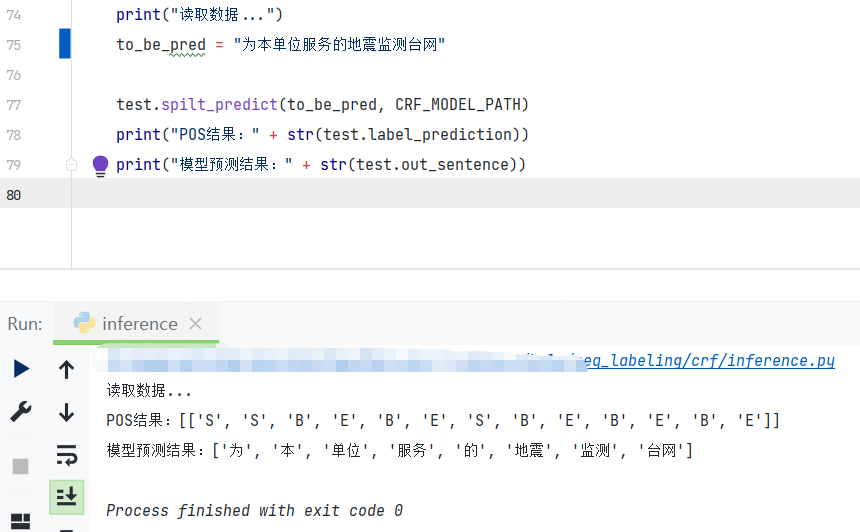
    <content type="html"><![CDATA[<p>使用CRF进行中文分词训练。本文主要从实际应用出发，讨论如何使用CRF进行训练和推理。如果是对其中数学原理有兴趣的同学，可以参考《统计自然语言处理》的相关内容，以及台大李宏毅老师的视频课等等。</p><h3 id="CRF-条件随机场"><a href="#CRF-条件随机场" class="headerlink" title="CRF 条件随机场"></a>CRF 条件随机场</h3><p>要使用CRF，就要先了解它最基本的一些概念。</p><p><a href="https://ericmiao.top/2022/03/24/CRF%E5%8E%9F%E7%90%86%E5%88%9D%E6%8E%A2/">打个广告，自己总结的一点点CRF知识。</a></p><p>其中对于应用，个人认为最重要的概念是：两个特征函数${s_l()}$和${t_k()}$。</p><p>${s_l()}$：状态特征函数，只与当前节点的观测值与隐藏标签有关。个人认为可以按照HMM中的emission发射概率来理解。</p><p>${t_k()}$：转移特征函数，与当前节点及其相邻节点有关。个人认为可以按照HMM中的transition转移概率来理解。</p><p>值得注意的是，特征函数是可以自己进行设计的。CRF++与crfsuite中都支持相应的自行设计特征函数，可以将CRF的“感受野”扩大。</p><p>针对上面两种特征函数，CRF有相对应的两个可学习参数<strong>λ</strong>和<strong>μ</strong>，通过学习获得。</p><h3 id="问题定义"><a href="#问题定义" class="headerlink" title="问题定义"></a>问题定义</h3><p>Input：观测序列O(observation)，条件随机场模型CRF(${s_l()}$，${t_k()}$)</p><p>Output：隐藏序列H(Hidden)</p><h3 id="训练"><a href="#训练" class="headerlink" title="训练"></a>训练</h3><p>CRF的训练主要是针对上面特征函数相关的两个参数的学习，在学习过程中，一般按照CRF简化的形式来表示，即<strong>f()<strong>表示特征函数，</strong>ω</strong>表示参数。主流的学习策略有：梯度下降、拟牛顿法、L-BFGS等等。以梯度下降法为例：</p><p>定义出损失函数(or 优化函数)${L(\omega)}$，再通过对<strong>ω</strong>求导，得到${\frac{\partial f(\omega)}{\partial \omega}}$，就可以通过一般的梯度下降方式求解参数了。</p><h3 id="训练代码"><a href="#训练代码" class="headerlink" title="训练代码"></a>训练代码</h3><p>请将<a href="https://github.com/global-nlp/knlp.git">global-nlp&#x2F;knlp</a>代码克隆到本地，</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">git <span class="built_in">clone</span> https://github.com/global-nlp/knlp.git</span><br><span class="line">pip install -r requirements.txt</span><br><span class="line">python knlp/seq_labeling/crf/train.py &#123;train_data_path&#125;</span><br></pre></td></tr></table></figure><p>上面的操作会将训练好的模型以pkl形式存储于knlp&#x2F;model&#x2F;crf下。</p><h3 id="预测"><a href="#预测" class="headerlink" title="预测"></a>预测</h3><p>预测的过程，实际上就是通过前面训练好的参数与模型对观测序列进行相应的计算与解码。</p><p>sklearn-crfsuite这个库的解码依然调用的是维特比算法，关于Viterbi算法，可以参考学长的博文：<a href="https://zhuanlan.zhihu.com/p/113170392">小李：Viterbi解码-可能是最易懂且全面的隐马尔可夫介绍（二）</a>。</p><h3 id="完整步骤"><a href="#完整步骤" class="headerlink" title="完整步骤"></a>完整步骤</h3><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">git <span class="built_in">clone</span> https://github.com/global-nlp/knlp.git</span><br><span class="line">pip install -r requirements.txt</span><br><span class="line">python knlp/seq_labeling/crf/train.py &#123;train_data_path&#125;</span><br></pre></td></tr></table></figure><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># !/usr/bin/python</span></span><br><span class="line"><span class="comment"># -*- coding:UTF-8 -*-</span></span><br><span class="line"><span class="keyword">from</span> knlp.common.constant <span class="keyword">import</span> KNLP_PATH</span><br><span class="line"><span class="keyword">from</span> knlp.seq_labeling.crf.inference <span class="keyword">import</span> Inference</span><br><span class="line"><span class="keyword">from</span> knlp.seq_labeling.crf.train <span class="keyword">import</span> Train</span><br><span class="line"></span><br><span class="line"><span class="comment"># init trainer and inferencer</span></span><br><span class="line">crf_inferencer = Inference()</span><br><span class="line">crf_trainer = Train()</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">crf_train</span>(<span class="params">training_data_path, model_save_file</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">    This function call crf trainer and inference. You could just prepare training data and test data to build your own</span></span><br><span class="line"><span class="string">    model from scratch.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    Args:</span></span><br><span class="line"><span class="string">        training_data_path:</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    Returns:</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    &quot;&quot;&quot;</span></span><br><span class="line">    crf_trainer.init_variable(training_data_path=training_data_path)</span><br><span class="line">    crf_trainer.load_and_train()</span><br><span class="line">    crf_trainer.save_model(file_name=model_save_file)</span><br><span class="line">    <span class="built_in">print</span>(</span><br><span class="line">        <span class="string">&quot;Congratulations! You have completed the training of crf model for yourself. &quot;</span></span><br><span class="line">        <span class="string">f&quot;Your training info: training_data_path: <span class="subst">&#123;training_data_path&#125;</span>. &quot;</span></span><br><span class="line">        <span class="string">f&quot;model_save_path: <span class="subst">&#123;model_save_file&#125;</span>&quot;</span></span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">load_and_test_inference</span>(<span class="params">model_save_file, sentence</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">    测试推理</span></span><br><span class="line"><span class="string">    Args:</span></span><br><span class="line"><span class="string">        model_save_file: string</span></span><br><span class="line"><span class="string">        sentence: string</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    Returns:</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    &quot;&quot;&quot;</span></span><br><span class="line">    crf_inferencer.spilt_predict(file_path=model_save_file, in_put=sentence)</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&quot;POS结果：&quot;</span> + <span class="built_in">str</span>(crf_inferencer.label_prediction))</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&quot;模型预测结果：&quot;</span> + <span class="built_in">str</span>(crf_inferencer.out_sentence))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&#x27;__main__&#x27;</span>:</span><br><span class="line"></span><br><span class="line">    training_data_path = KNLP_PATH + <span class="string">&quot;/knlp/data/hanzi_segment.txt&quot;</span></span><br><span class="line">    model_save_file = KNLP_PATH + <span class="string">&quot;/knlp/model/crf/crf.pkl&quot;</span></span><br><span class="line">    crf_train(training_data_path=training_data_path, model_save_file=model_save_file)</span><br><span class="line"></span><br><span class="line">    sentence = <span class="string">&quot;从明天起，做一个幸福的人，关心粮食与蔬菜。&quot;</span></span><br><span class="line">    load_and_test_inference(model_save_file=model_save_file, sentence=sentence)</span><br></pre></td></tr></table></figure>]]></content>
    
    
    <summary type="html">参与NLP有关项目，记录学习所得。</summary>


    <category term="技术学习" scheme="http://example.com/categories/%E6%8A%80%E6%9C%AF%E5%AD%A6%E4%B9%A0/"/>
    
    
    <category term="NLP" scheme="http://example.com/tags/NLP/"/>
    
  </entry>
  
  <entry>
    <title>CRF原理初探</title>
    <link href="http://example.com/2022/03/24/CRF%E5%8E%9F%E7%90%86%E5%88%9D%E6%8E%A2/"/>
    <id>http://example.com/2022/03/24/CRF%E5%8E%9F%E7%90%86%E5%88%9D%E6%8E%A2/</id>
    <published>2022-03-24T13:39:02.000Z</published>
    <updated>2022-07-17T18:18:42.499Z</updated>
    
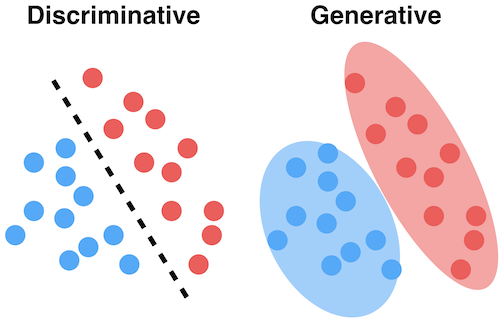
    <content type="html"><![CDATA[<p><em>写在前面：本人刚刚入门NLP三个月，希望通过记录博客来巩固自己的知识，增进对知识的理解。</em></p><p>本人在进行序列标注(sequence tagging)方面的学习时，最先接触到两个经典的统计学习方法：一个是HMM(隐马尔可夫模型)，一个是CRF(条件随机场)。在查阅CRF有关的文章时，发现大体分为两类：一类硬核解析，从公式出发；一类重视概念，从原理出发。很多博文都写的很好，不过本人认为，理解CRF，数学与概念都要重视，才能见效。希望这篇肤浅的文章能够帮助像我一样刚入门的NLPer扫去一些疑惑。</p><h3 id="一、序列标注-Sequence-tagging"><a href="#一、序列标注-Sequence-tagging" class="headerlink" title="一、序列标注 Sequence tagging"></a>一、序列标注 Sequence tagging</h3><p>了解CRF之前，先从序列标注开始讲起。</p><p>序列标注问题是NLP中的基本问题，简单来说就是对一段序列进行标注或者说打标签。许多经典的NLP任务，像词性标注、分词、命名实体识别、拼音输入法等等，本质上都是对句子中的元素进行标签预测。序列标注也是很多更高层次NLP任务的前驱，因为最近做的是分词任务，所以简单说明一下常见的标注方式，便于读者后续阅读：</p><ol><li>BIO标注：B-Beginning 一个词的开始；I-Inside 一个词之中；O-Outside 独立的字。(常见于命名实体识别，B-Name等等形式)</li><li>BMES标注：B-Begin 一个词的开始；E-End 一个词的结束；M-Middle 一个词的中间；S-Single 独立的字。（常用于中文分词）</li><li>BIOES标注：和1、2中字母含义相同。</li></ol><p>接下来，一起来看看CRF吧！</p><h3 id="二、为什么需要CRF？"><a href="#二、为什么需要CRF？" class="headerlink" title="二、为什么需要CRF？"></a>二、为什么需要CRF？</h3><p><strong>先说个人结论：CRF能在训练语料中学习到更多信息，表征出更多特征。</strong></p><p>我看过一个很有趣的例子，<a href="http://blog.echen.me/2012/01/03/introduction-to-conditional-random-fields/">原文在这儿</a>，<a href="https://zhuanlan.zhihu.com/p/104562658">翻译在这儿</a>，大概思想就是，你手头有一组图片，图片顺序展示了一个人一天的生活。现在，需要你对这一组图片进行标注，注明这个人在做什么事情，你会怎么去做？</p><p><strong>一般来说，我们会一张一张地看，有时候还需要借助前后照片进行推理。因为这组图片是具有时空顺序关系的，上一张图片如果在吃饭下一张图片不可能会在做饭。</strong></p><p>CRF的核心思想也是这样，通过对某一时刻与相邻时刻之间的特征进行学习，来获得更好的预测效果。其实如果是之前有了解神经网络的朋友的话，看到这里也一定会想到LSTM模型吧？LSTM模型也很适用于解决序列类型问题，因此，像模型Bi-LSTM会后接CRF层来获得更丰富的标签之间的特征信息。</p><p>为了显示CRF在分词时对训练数据更强的学习能力，展示一个例子（拿HMM作比较）：</p><p>对于训练数据中出现过的句子(BMES标注)： <strong>[为&#x2F;S 本&#x2F;S 单&#x2F;B 位&#x2F;E 服&#x2F;B 务&#x2F;E 的&#x2F;S 地&#x2F;B 震&#x2F;E 监&#x2F;B 测&#x2F;E 台&#x2F;B 网&#x2F;E]</strong></p><p>对应的分词结果应该为： <strong>[‘为’, ‘本’, ‘单位’, ‘服务’, ‘的’, ‘地震’, ‘监测’, ‘台网’]</strong></p><p><strong>HMM预测结果：</strong></p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/img/hmm.png?versionId=CAEQFhiBgMDapJbn_RciIDNkNzcxY2NhMWI3ODQ0N2VhYTQyY2Y3NzY1MmNhMWE3"></p><p><strong>CRF预测结果：</strong></p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/img/crf.png?versionId=CAEQFhiBgMC_pJbn_RciIDIzNTBmNTljM2VlMTQyMTJiYmNlM2FhYzMxNWI1NWM5" alt="CRF的分词结果"></p><p><strong>可以看出，CRF在遇到训练数据中出现过的序列，能体现出自身学习到的信息进行标注，对于训练数据提供的潜藏信息的表征能力更强。</strong></p><p>接下来，让我们更进一步地了解CRF的性质与不同之处。</p><h3 id="三、判别式-Discriminative-模型与生成式-Generative-模型"><a href="#三、判别式-Discriminative-模型与生成式-Generative-模型" class="headerlink" title="三、判别式(Discriminative)模型与生成式(Generative)模型"></a>三、判别式(Discriminative)模型与生成式(Generative)模型</h3><p>这两个概念是经常容易碰到的概念，也是我觉得比较基础不能混淆的知识。</p><p>先放一张直观的图：</p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/img/dis.png?versionId=CAEQFhiBgIDxpJbn_RciIDQ3MmE1ODU1ZDRhNjRhMGU4MjllYTdkYTI4NTg3OGI0"></p><ol><li><p>什么是判别式？</p><p>顾名思义，判别式就是，根据xx判断xx。对于输入X，预测标记Y，即条件概率P(Y|X)。所以在我的理解中，判别式其实是在训练中学习得到一个边界条件，或者说分裂面，对于模型的输入，可以直接通过这个判断标准来进行分类。像上图中的左半部分，其实得到的是两个类别的不同点，因此判别式在分类预测任务中有着非常不错的表现。</p></li><li><p>什么是生成式？</p><p>顾名思义，生成式就是，根据训练数据生成多个种类的“模型”，而不是像判别式一样去学习各个种类之间的分界。因此，这种方式计算的是一种联合概率P(X,Y)，对于输入X，计算多个联合概率，取最大的作为最有可能的情况。像上图中的右图所示，生成式会学习出比较完整的这一整个类的边界，而不是仅仅关注类之间的关系。</p></li><li><p>举个栗子</p><p><em>现在我的训练数据里有可口可乐与百事可乐，然后我向训练好的机器输入一张含有易拉罐的图片。</em></p><p><strong>假如是判别式模型：先对图片提取出特征信息，判别式模型通过一些显著的区分特征(颜色、LOGO等等)，直接可以给出是可口可乐的概率和是百事可乐的概率。</strong></p><p><strong>假如是生成式模型：先对图片提取出特征信息，再通过训练时已经对可口可乐和百事可乐建立好的模型，逐个传入图片特征进行计算，最后概率最高的那个就是预测得到的种类。</strong></p></li><li><p>和CRF有什么关系？</p><p>HMM是生成式模型，CRF是判别式模型。为什么？因为HMM的训练过程是对所有样本建立一个统计学的概率密度模型，这个模型是通过HMM当中的转移矩阵和发射矩阵实现的。而CRF不同，CRF计算的是条件概率，直接对训练数据中获取的分类规则进行建模，例如前后位置数据与当前位置数据之间的关系等等。CRF更注重的是通过特征函数学习到序列的特征特点，以及序列之中的约束条件。这也就是为什么CRF不会出现<strong>第二点</strong>中HMM出现的问题，因为HMM只对一个字以及它的下一个字是什么做了概率估计，并没有真正关注到整句话里的前后特征。</p><p>事实上，判别式模型与生成式模型是有一定的转化关系的。逻辑上可以理解为，生成式模型对各个种类建立模型之后，其实也得到了各个模型的边界，提供了转化为判别式的前提条件。对HMM有所了解的读者也可以思考一个问题，HMM与CRF是否存在一定的转化关系？</p></li></ol><h3 id="四、从马尔可夫到CRF"><a href="#四、从马尔可夫到CRF" class="headerlink" title="四、从马尔可夫到CRF"></a>四、从马尔可夫到CRF</h3><ol><li><p>随机场</p><p>在一个样本空间中，各个点的值是根据某种分布随即赋予的。</p></li><li><p>马尔可夫随机场</p><p>随机场+马尔可夫性，即随机场中某个位置只与其相邻位置的值有关，与不相邻位置的值无关。</p></li><li><p>条件随机场</p><p>特殊的马尔科夫随机场，Y满足马尔可夫性。随机场中每一个位置下还有一个观测值X(observation)，本质上，就是给定了观测值X的随机场，这个场中有X和Y两种随机变量，且Y满足马尔可夫性。</p></li><li><p>线性链条件随机场 Linear-CRF</p><p>最常见的CRF的形式，特点是X和Y都具有相同的结构，并且满足马尔可夫性，即随机场中某个位置只与其相邻位置的值有关，与不相邻位置的值无关。</p><p>Linear-CRF示意图：</p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/img/L-crf.png?versionId=CAEQFhiBgIC2pJbn_RciIDBhNmY0ZjA4ZWEzYjRkNWM4OGQwYjU3YzcyNjRkNzA4"></p></li></ol><h3 id="五、最大熵模型与CRF"><a href="#五、最大熵模型与CRF" class="headerlink" title="五、最大熵模型与CRF"></a>五、最大熵模型与CRF</h3><ol><li><p>最大熵 MaxEnt</p><p>最大熵模型不仅仅应用在序列标注任务上，该模型最伟大的地方在于，引入了特征函数以及其相对应的参数来对输入的整体特征进行学习。数学公式就不搬上来了，其实整体上与CRF最后的结果很相似。</p><p><strong>个人理解中，特征函数的引入是为了引导模型去学习我们认为对于任务有帮助的一些特征。</strong> 通过这种方式建立起对条件概率的计算，成为了判别式模型。而单纯的生成式模型不含有特征函数，直接对整个数据的分布进行相应的学习。</p></li><li><p>最大熵马尔可夫模型 MEMM</p><p>MEMM相比于HMM模型进步的地方在于，学习了MaxEnt的方法来计算条件概率。但是它的局限性在于，MEMM是在每个局部节点进行计算的基础上，再合并起来。这样做的问题在于，每一步的最大熵模型得到的条件概率仅基于与这一点相关的两点的信息，并且也只是在这个局部进行归一化，缺乏全局性。</p><p>MEMM的进步之处在于，引入了判别式的方法，又基于HMM的性质在局部进行运算，速度也很快。</p></li><li><p>CRF中的特征函数</p><p>CRF更像是以上几种方法的结晶。</p><p>CRF中不可或缺的概念就是特征函数。一开始在我看CRF的时候，突然蹦出两个特征函数搞得我一头雾水，后来我才发现原来都是在前人不断地研究和试错中慢慢摸索出来的模型，respect。特征函数其实是人为定义的，比如在分词任务中，我不希望动词后面会加形容词或者动词，那么我可以通过设置特征函数来明确这一点，给机器一个调整的方向。</p><p>CRF的特征函数有两种：</p><p>① 节点上的状态特征函数：<br>$<br>s_l(y_i,x,i),i&#x3D;1,2,…,L<br>$</p><p>表示出节点上观察序列与对应状态之间的特征。</p><p>② 节点之间的转移特征函数：<br>$<br>t_k(y_{i-1},y_i,x,i),k&#x3D;1,2,…,K<br>$</p><p>表现出节点之间(这里是前一个节点与当前节点)的特征关系。</p></li></ol><h3 id="六、CRF公式浅析"><a href="#六、CRF公式浅析" class="headerlink" title="六、CRF公式浅析"></a>六、CRF公式浅析</h3><p>进入公式环节，在此之前，还要先补充一点方便理解的知识：</p><ol><li><p>概率无向图</p><p>实际上，如果联合概率分布满足成对，局部或全局马尔可夫性，就称此联合概率分布为概率无向图模型。这个定义和上面马尔可夫场的定义是相似的。也就是说，可以把马尔科夫场看作一个概率无向图，点是随机变量，边是变量间关系。而条件随机场又可以看作是特殊的马尔科夫随机场，故而可以用概率无向图来进行表示。</p><p>在概率无向图中，还有一个很重要的概念，叫做最大团。</p><p><img src="https://4myblog.oss-cn-beijing.aliyuncs.com/img/graph.jpg?versionId=CAEQFhiBgIDQpJbn_RciIGY4Y2RlM2RkN2QwYjRjMDNhYTZhNjE5YzMxYWQyNDhm"></p><p><a href="https://zhuanlan.zhihu.com/p/34261803">感谢这篇文章</a>，这组图片说明的很清楚。其实很简单，极大团中是全连接的一组节点，再多一个节点就会破坏这种全连接的条件限制。最大团就是极大团中节点数最多的极大团。</p><p>那我们为什么需要最大团呢？因为根据一个很数学的定理(Hammersley-Clifford 定理)，概率无向图模型的联合概率分布P(Y)可由最大团得到：</p><p>$<br>P(Y) &#x3D; \frac{1}{Z}\sum_{Y}\psi_c(Y_c)<br>$</p><p>$<br>Z &#x3D; \sum_Y \prod_c\psi_c(Y_c)<br>$</p><p>$<br>\psi_c(Y_c) &#x3D; e^{-E(Y_c)}<br>$</p><p>$<br>E(x_c) &#x3D; \sum_{u,v\in C,u \neq v}\alpha_{u,v}t_{u,v}(u,v) + \sum_{v \in C}\beta_v s_v(v)<br>$</p><p>第一条公式里的c，就是无向图的最大团。${Y_c}$代表了节点上的随机变量，${\psi_c}$是一个严格正函数，Z是归一化因子。   </p><p>第二条公式是归一化因子的计算公式。与第一条公式相同，只不过增加了对所有最大团的连乘。</p><p>第三和第四条公式是对${\psi}$函数，或者说，势函数的进一步解释。但实际上，并没有规定${\psi}$函数一定是这样。<br>因为这里的定义与物理中的玻尔兹曼分布有关，所以一般这样设置势函数。这里的${\alpha}$与${\beta}$都是参数，t()与s()是特征函数。<br>还有一个细节，这里的特征函数t()是关于极大团中两个节点之间的关系，而s()是关于节点单独的。这与CRF中特征函数的定义很相似。</p><p>公式没有看得很明白也没有关系，读者是否发现，第四条公式非常的眼熟？让我们继续来观察一下CRF的公式。</p></li><li><p>CRF公式</p><p>为了便于说明，以线性条件随机场为例。</p><p>CRF的参数化定义是这样的：<br>$<br>P(y|x) &#x3D; \frac{1}{Z(x)}exp(\sum_{i,k}\lambda_kt_k(y_{i-1},y_i,x,i) + \sum_{i,l}\mu_ls_l(y_i,x,i))<br>$</p><p>$<br>Z(x) &#x3D; \sum_y exp(\sum_{i,k}\lambda_kt_k(y_{i-1},y_i,x,i) + \sum_{i,l}\mu_ls_l(y_i,x,i))<br>$</p><p>是不是很眼熟？其实就是把概率无向图中的公式整合了一下嘛！<strong>λ</strong>和<strong>μ</strong>都是可学习的参数，特征函数也和我们前面定义的一样。其实，MEMM最大熵的计算公式也和这个结果非常相似，因为信息熵的定义和设计本身就与这里的势函数有一些相似之处。但是它与CRF不同的地方主要在于，归一化因子的计算不同。MEMM计算的归一化因子是各个节点上归一化因子连乘得到(个人观察，不一定正确)；CRF直接计算全局的归一化因子，因此全局性更强。</p><p>看到这里，是不是大概明白CRF的公式来源于哪里了？</p><p>为了表达方便，一般会对公式进行简化如下：</p><p>$<br>P(y|x) &#x3D; \frac{1}{Z(x)}exp(\sum_{k}\omega_kf_k(y,x))<br>$</p><p>$<br>Z(x) &#x3D; \sum_Y exp(\sum_{k}\omega_kf_k(y,x))<br>$</p><p>用<strong>ω</strong>来代替表示两个参数，用 <strong>f()</strong> 来代替表示两个特征函数。用了这个公式之后，其实我们能发现CRF的一些工作原理。满足特征函数数量越多，相应的条件概率值就会越大(不将<strong>ω</strong>考虑进来，将<strong>ω</strong>考虑进来的话应该加一个前提：在我们希望学习的特征情况下。)</p><p>至此，就可以通过一些算法(梯度下降、L-BFGS等等)进行学习，得到参数了。</p></li></ol><h3 id="七、总结"><a href="#七、总结" class="headerlink" title="七、总结"></a>七、总结</h3><p>个人认为，CRF最核心的点莫过于引入全局性。上面的例子讲的是Linear-CRF的情况，实际上，CRF可以复杂得多，这一切都由你的特征函数来确定。CRF的这种设计方式使得它能挖掘出更多的标签之间的约束关系和信息，但是缺点也比较明显，就是训练速度会比较慢。<br><strong>最后，感谢俊毅哥还有KNLP组中其他的小伙伴们！！</strong></p>]]></content>
    
    
    <summary type="html">参与NLP有关项目，记录学习所得。</summary>


    <category term="技术学习" scheme="http://example.com/categories/%E6%8A%80%E6%9C%AF%E5%AD%A6%E4%B9%A0/"/>
    
    
    <category term="NLP" scheme="http://example.com/tags/NLP/"/>
    
  </entry>
  
  <entry>
    <title>亚太数模总结</title>
    <link href="http://example.com/2022/01/14/apmcm/"/>
    <id>http://example.com/2022/01/14/apmcm/</id>
    <published>2022-01-14T13:39:02.000Z</published>
    <updated>2022-07-17T18:11:54.083Z</updated>
    
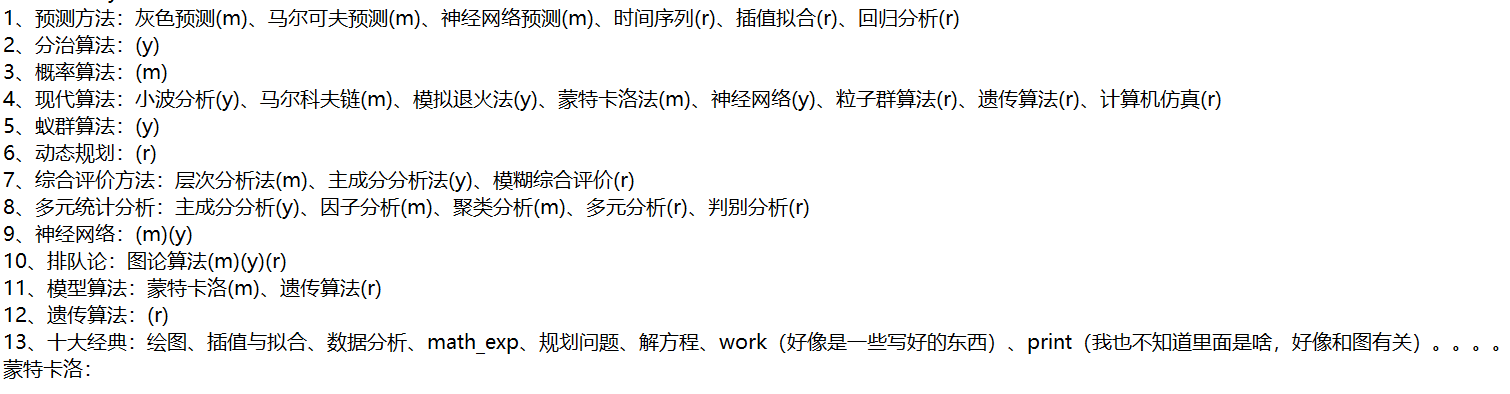
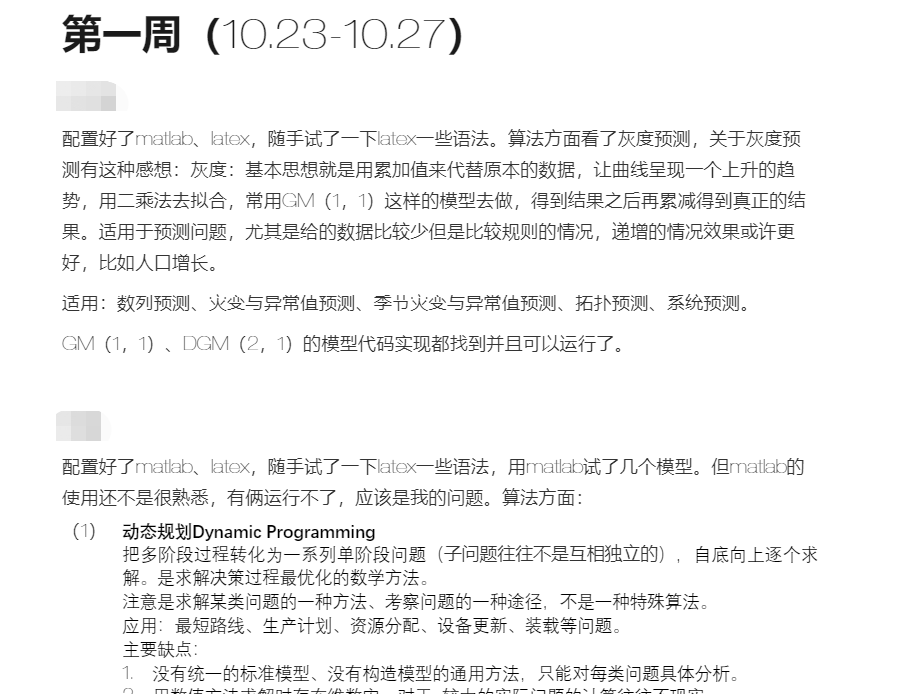
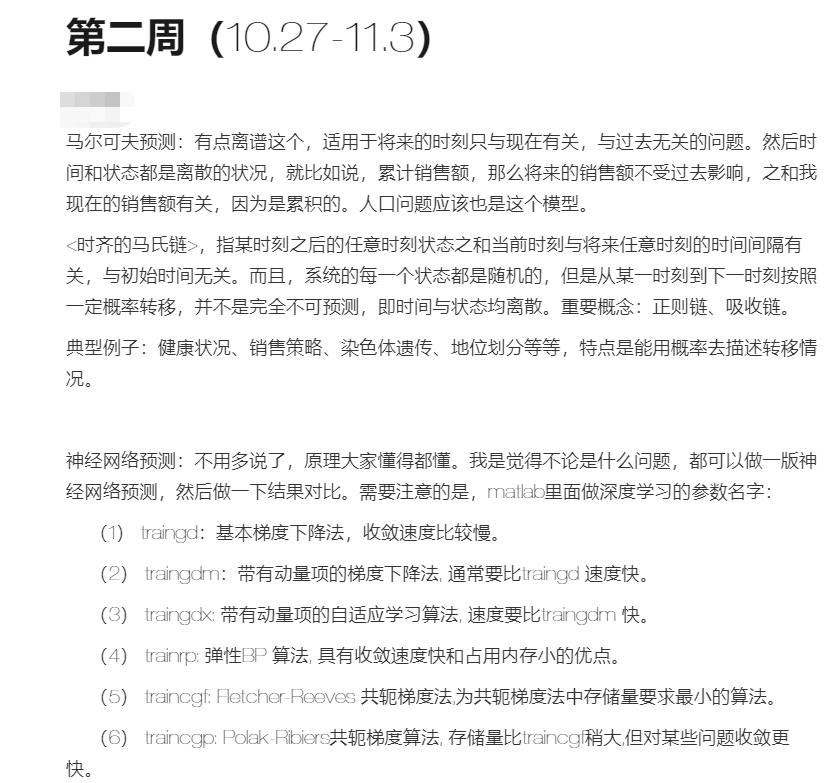
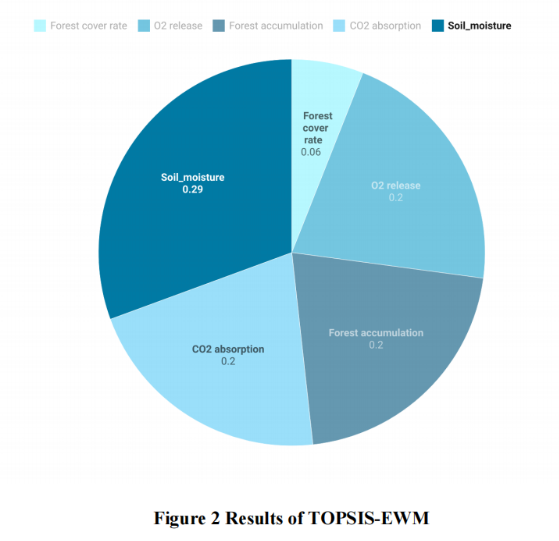
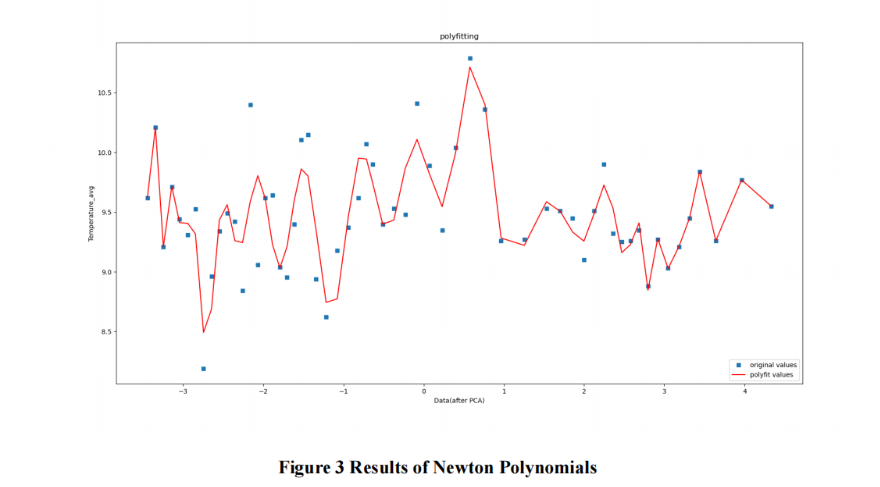
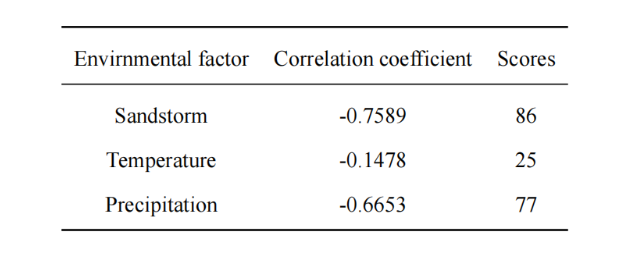
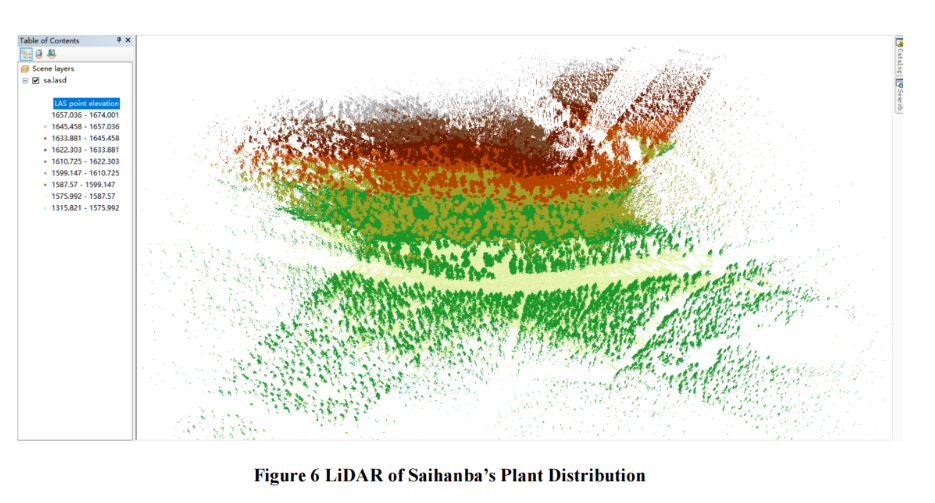
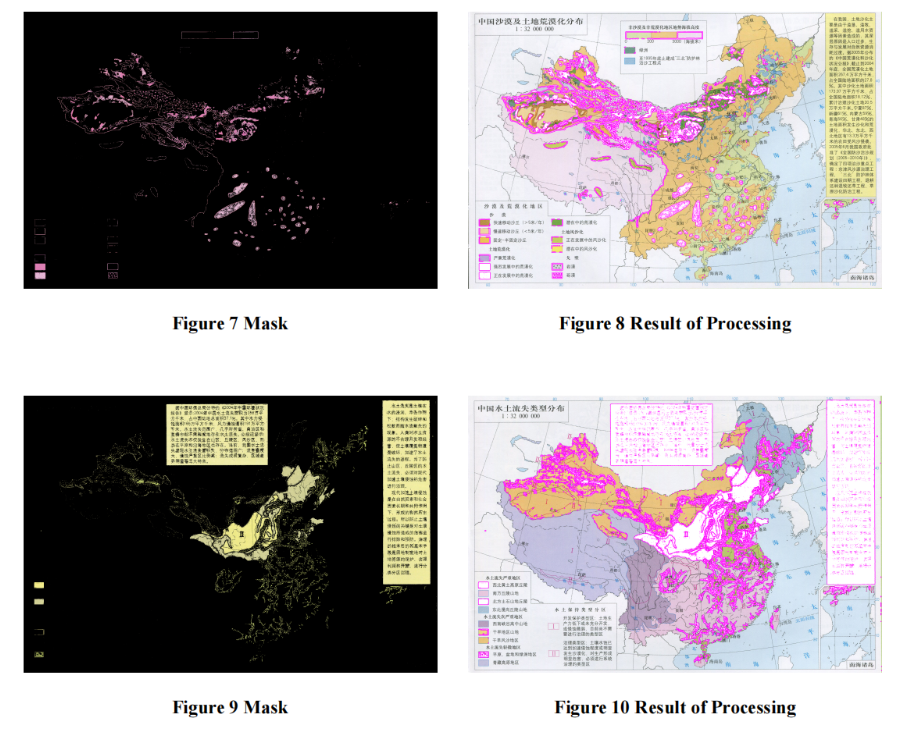
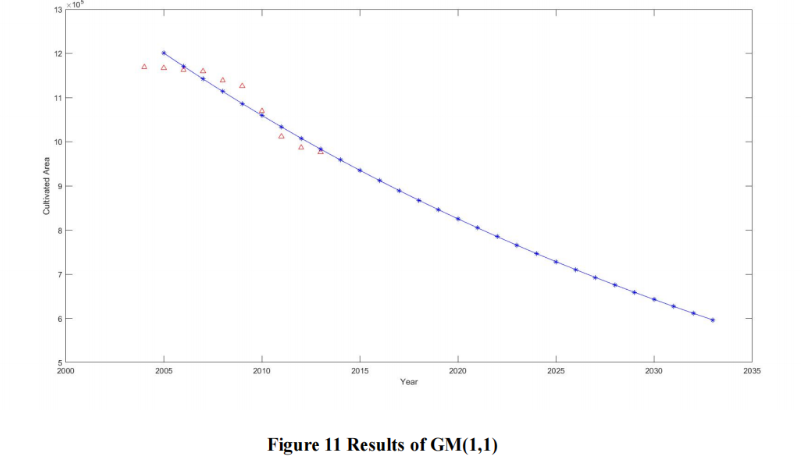
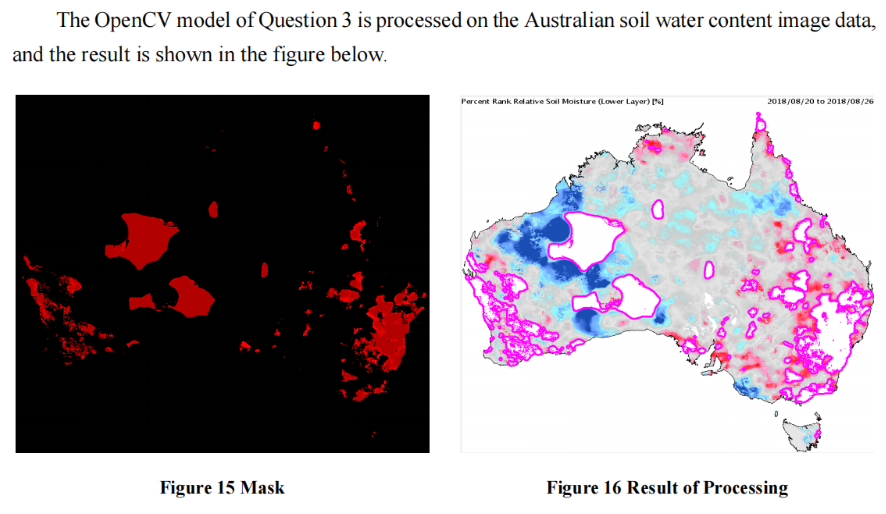
    <content type="html"><![CDATA[<h3 id="前期准备"><a href="#前期准备" class="headerlink" title="前期准备"></a>前期准备</h3><ol><li><p>组队</p><p>不论是什么比赛，团队是我认为最重要的key factor。对于一项我比较重视的比赛，我往往会选择作为队长参加，因为我想自己选择我最信任的朋友来组队和奋斗。</p><p>这里插一句题外话，我真的很感激一路上的合作伙伴们：写书的时候的李帕、冰糖、zang、juns、kouzong；服创时候的谌总、cyy、ruia、佳宁姐，后期加盟的林导林铁蛋；互联网+的时候被强势带飞的Jacob学长；亚太数模的cherish和ruia……感谢队友们对我的信任，也感谢很多人一路上不离不弃。</p><p>说回亚太，一般来说，数模比赛的队友会是这么一个配置模式：</p><p><strong>建模手(编程手亦可) * 1</strong></p><p><strong>数学手(个人理解是出solution的人) * 1</strong></p><p><strong>英语 * 1</strong></p><p>当时我组队的时候也没想太多，比起按照配置<strong>对号入座</strong>，我认为还是能把话说到一块去的人更合适，于是找了熟悉且靠谱的朋友开干。其实整体做下来，感觉这个配置模式是可以灵活替换的，也并不是一个基准(当然，也很可能是因为我们都是第一次参加，比较混乱)。实际上我们队伍的实际情况是：</p><p><em>Day 1：我和cherish是数学手思考solution，ruia做数据的收集</em></p><p><em>Day 2：我和cherish是编程手，通宵把solution付诸实践，ruia变成论文手兼数据收集</em></p><p><em>Day 3：ruia变成数学手，针对solution做modify，cherish继续编程建模，我变成论文手写摘要</em></p><p><em>Day 4：ruia提出一个很有趣的解决方案，我又变成编程手实现，cherish写论文。</em></p><p>所以实际上呢，职责是跳脱的，也是混乱的。从一个新手的角度出发，我还是鼓励大家从综合实力强合得来的朋友组队，第一次很难做到职责分明，所以需要大家都能时刻统一意见然后具有多面的解决问题的能力，及时帮忙救火。</p></li><li><p>前一个月</p><p>没错，我们提前一个月就开始有一些规划。大抵是一个月或者是三个星期吧，记不太清楚。这是我当时认为很重要的事情，因为我们都是没有参加过数模比赛的小白，<strong>所以我认为需要对基础的一些模型进行涉猎和了解，对一些数学概念做基本的学习。</strong>于是当时我统计了一些很常见的在数模比赛中比较基础的方法，然后每个人分门别类地安排去学习，每周汇报一次(类似组会)，把这个模型有关的知识记录下来，大家都能看到。</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328012636474.png" alt="image-20220328012636474"></p><p><strong>上图是第一次开会后分配的任务。</strong></p><p><strong>下面截取一部分我们每周的一些总结：</strong></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328013108366.png" alt="image-20220328013108366"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328013241975.png" alt="image-20220328013241975"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328013307974.png" alt="image-20220328013307974"></p><p>当然，事实上比赛最后绝大部分的算法没有用到，但是毕竟我们的<strong>目的是学习嘛</strong>，学到了就不亏，何况还拿了奖。</p><p>现在回过头来看看，大家还是很努力的，棒！</p></li></ol><h3 id="比赛开始"><a href="#比赛开始" class="headerlink" title="比赛开始"></a>比赛开始</h3><ol><li><p>Timeline</p><p>先说一下时间线。</p><div class="mermaid">ganttdateFormat  YYYY-MM-DDtitle 亚太时间管理甘特图section 我理解问题                      :done,    des1, 2021-11-25,12h思考解决方案                      :active,  des2, 2021-11-25,2d编程建模                     : crit,  done,      des3, after des1, 2d论文写作:active, after des2,2dsection ruia理解问题                      :crit, done, 2021-11-25,12h查找相应数据与文献                      :crit, done, 2021-11-25,2d论文准备工作                      :crit, done, 2021-11-26,36h完善解决方案                                 :crit, 2021-11-27,24h论文写作:active, after des2,2dsection cherish理解问题                     :crit, done, des4,2021-11-25,12h思考解决方案                      :active,  des1, 2021-11-25,1d数据集处理                   :done,after des4,36h 编程建模                     : crit,done    ,    des3, after des1, 2d论文写作:active, after des2,2d</div><p>借用一下甘特图，使用不是很严谨，不过大体流程八九不离十。我把“完善解决方案”标红了，因为这个部分我认为是当时比较关键的一件事情，把四个问题的解决方案串了起来。</p><p>总体上，最耗时的工作是：<strong>数据搜集、编程、写作。</strong>而且比赛第一天正好我是满课，基本上没有做特别多的工作。主要的部分都是第二天通宵和周六周日做完的。接下来，我也会围绕这几个耗时最长的部分谈谈感受。</p></li><li><p>数据搜集</p><p>由于我们选了技术含量相对最低的C题，分析塞罕坝的环境影响并且对研究结果做迁移，我们需要搜集特别多的数据来进行分析。</p><p><strong>一些传送门：</strong></p><p><a href="https://data.stats.gov.cn/index.htm">国家统计局</a></p><p><a href="https://en.tutiempo.net/climate">气候数据</a></p><p><a href="https://www.noaa.gov/">NOAA</a></p><p><a href="https://data.mendeley.com/">这个网站也不错，搜集数据集，但是好像要科学上网</a></p><p>…</p><p>很多网站也记不清了，大体上就是广撒网式搜刮数据。北京市的沙尘天气数据甚至是在一篇报告中获得的，总的来说就是，各种搜索引擎一起使用，有必要的话可以借助爬虫。</p><p>数据搜集起码占了我们前两天75%的时间，没有数据，无从开始。</p><p>这里也有一点个人建议：<strong>数据总是很零碎的，尤其是环境题，不要强求从解决方案的角度搜集所需要的数据，而是要从搜索到的数据上建立解决方案。</strong></p></li><li><p>编程建模</p><p>获取一定数量的数据后，就是建模环节。因为我们这次第一第二题的方向是做分析，所以基本上是一些分析方法的使用。</p><p>很多人说，层次分析法、灰度预测等等，都是很简单老套的模型，没有任何竞争力，但其实它们也有存在的意义。刚拿到手的数据，可以用简单的方法跑一下看看结果是否和自己猜测的接近，做一个初步的判定之后也能为解决方案确定方向。这里大概说一下我们要解决的问题以及最后我们的整体设计：</p><p><em>问题：</em></p><p><em>Q1：根据各种环境因子建立塞罕坝环境评估模型，对比分析塞罕坝治理前与治理后对周边环境的影响。</em></p><p><em>Q2：评估塞罕坝治理对北京抗风沙能力的影响，量化评估塞罕坝在其中的作用。</em></p><p><em>Q3：对塞罕坝的治理模式做迁移，找到国内适合的地点建立自然保护区。</em></p><p><em>Q4：同Q3，但是在亚太地区做迁移，给出技术性报告。</em></p><p><strong>解决思路：</strong></p><p>我们先对塞罕坝四十年来的几项数据<strong>做了层次分析</strong>，得出了大概的因子权重，“土壤含水量”是所有塞罕坝带来的环境变化中最重要的一个因子。然后基于此，我们进行了进一步的<strong>主成分分析与熵权法分析，确实获得了相同的结果。</strong></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328110730892.png" alt="image-20220328110730892"></p><p>接着，我们以承德市平均气温作为塞罕坝周围环境的评估标准，用牛顿插值去拟合曲线观察气温变化，<strong>发现确实越来越趋于稳定，证明塞罕坝有起到一定的调理作用。</strong></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328111041938.png" alt="image-20220328111041938"></p><p>针对第二题，我们试图在塞罕坝的环境因子与北京市的沙尘天气数据之间建立联系。基于第一题的结果，我们选取含水量和二氧化碳吸收量作为代表，计算其与北京沙尘天气变化的<strong>关系系数</strong>，发现结果为0.8，<strong>证明了塞罕坝对北京市抵御风沙确实起到重要作用。</strong></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328111540947.png" alt="image-20220328111540947"></p><p>基于第一题的结果，对塞罕坝模式进行迁移的基础，是找到自然环境相似的地点。我们考虑了三项重要区位特征：水土流失、土地荒漠化、植被类型。逻辑是这样的：<strong>通过opencv对全国水土流失与土地荒漠化地图进行掩膜，提取和塞罕坝色块特征相同的区域，再比较它们与塞罕坝的植被特征(这里是基于我们找到的LiDAR数据)是否相似，来选取合适的地点。</strong></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328112330603.png" alt="image-20220328112330603"></p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328112359077.png" alt="image-20220328112359077"></p><p>最后，选取榆林市作为例子进行自然保护区尺度评估。<strong>借助榆林市政府公开的政府工作报告中的各类用地面积，</strong>使用简单的灰度预测来预测近年来可用于建设自然保护区的区位面积。</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328112612134.png" alt="image-20220328112612134"></p><p>问题四的解决思路和三相同，找相同区位特征，最后选取了澳大利亚的中部与西南部。</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/image-20220328112700797.png" alt="image-20220328112700797"></p></li><li><p>论文写作</p><p>有了solution，最后就是形成论文。实际上，摘要是最重要的部分，最好是想好一个问题的解决方案就进行记录。可以先通过谷歌机翻，然后再人工润色。</p><p>除了摘要，后面大体上的写作逻辑就是：问题描述、模型描述、算法原理、实验结果、分析结论。这样的逻辑写到最后，其实比想象中要顺利很多。强力推荐新手们就算以前没接触过，也要<strong>入门一下latex</strong>，写起来真的比word方便很多，也有很多现成的模板可以使用。</p><p>到了论文写作这一部分，其实也都是很细节的问题。比如图的脚注、表格的格式等等，很折磨人。因为前几天通了一次宵，把很多精力都留在了建模上，最后细扣论文的时候我简直像一具行尸走肉。</p><p>如果下次还参加的话，我给自己的建议是：<strong>论文写作可以提前开始。</strong>在建模的过程中就可以及时记录结果和素材，不要等最后再回过头来看自己的代码和结果。</p></li></ol><h3 id="赛后碎碎念"><a href="#赛后碎碎念" class="headerlink" title="赛后碎碎念"></a>赛后碎碎念</h3><p>人生第一次真正意义上的通宵，献给了这次比赛。说实话，打完比赛之后那周，上早八的时候都能感受到心律不齐，还患上了“塞罕坝”PTSD，刚交完论文第二天，形策课上听到塞罕坝竟然不自觉地有点反胃….Anyway，当初是很难受，但是现在想想也都是很有趣的经历：</p><p><strong>和cherish通宵前，我大放阙词：“我不可能睡着”。他嘲讽我说，一般这么说的人三点就睡了。事实上，我们最后都干到了天亮，然后同时昏倒在桌前。</strong></p><p><strong>和ruia、cherish在咖啡厅，吃了黄焖鸡、鸡公煲，大家闲聊些有的没的。</strong></p><p><strong>写论文的时候回看模型，突然发现跑的结果和我预想中完全相反，也和cherish的结果完全相反，吓得我一头冷汗，结果一看是数据集给错了。</strong></p><p><strong>ruia说到可以用土地荒漠化地图这种来做分析的时候，大家都很高兴，因为把所有题目都串起来了，所以我在“完善模型”那里表了红色。</strong></p><p><strong>正赛第一天遇到zngg，我不紧不慢的拿着圣代去实验室，他说：“你怎么这么悠闲！”可他不知道，我当时也慌的一批。</strong></p><p><strong>想找我们的建模课老师当指导老师，结果直到比赛结束我们才联系上他。</strong></p><p><strong>最后一天晚上，交作品前，我突然发现论文脚注标错了，是cherish的部分，赶紧看看他睡了没，结果真睡了，笑死，差点去他宿舍爆破他。</strong></p><p>总之，很有趣，很有收获。</p>]]></content>
    
    
    <summary type="html">大二上，获亚太区数学建模大赛一等奖。</summary>


    <category term="比赛经历" scheme="http://example.com/categories/%E6%AF%94%E8%B5%9B%E7%BB%8F%E5%8E%86/"/>
    
    
    <category term="数模" scheme="http://example.com/tags/%E6%95%B0%E6%A8%A1/"/>
    
  </entry>
  
  <entry>
    <title>服创总结</title>
    <link href="http://example.com/2021/09/05/sum/"/>
    <id>http://example.com/2021/09/05/sum/</id>
    <published>2021-09-05T13:39:02.000Z</published>
    <updated>2022-07-17T18:18:43.894Z</updated>
    
    <content type="html"><![CDATA[<p>大学第一次参加全国性的比赛，八个多月下来，有遗憾，有收获。以此博客作为记录。<br>（写这个博客还有一个原因，我写好的总结因为社会实践只能交一篇所以当时白写了，不能浪费！）<br>#总结<br>先将经验写在前面以防忘记：</p><p>1、大型比赛最重要的出发时的心态。我始终认为我们从什么都不会走到最后的国二，很重要的就是心态方的足够好。第一次开会的时候我就一直说，我们是为了学新东西来参加的比赛，大家不要想着名次什么的，毕竟我们从0到1，很难一次性有很大的成绩。就是抱着这种心态，我们一路走到最后。</p><h3 id="所以，不论什么比赛，少一点功利，多一点虔诚。"><a href="#所以，不论什么比赛，少一点功利，多一点虔诚。" class="headerlink" title="所以，不论什么比赛，少一点功利，多一点虔诚。"></a>所以，不论什么比赛，少一点功利，多一点虔诚。</h3><p>2、服创这类创新创业比赛，最看重两点：IDEA、PPT。前者决定了你能走多远，后者决定了你能走多高。前期，idea是最重要的，一个新颖的创意加上可行的实现方式，能保证你走过第一道关卡。而后期进入答辩环节，PPT更加重要，毕竟，将你的idea展示给别人看也是很重要的一部分。</p><h3 id="idea一定要经过自己的思考，不要人云亦云，即使是你导师给了一个新的idea，也要有自己的思考与判断。"><a href="#idea一定要经过自己的思考，不要人云亦云，即使是你导师给了一个新的idea，也要有自己的思考与判断。" class="headerlink" title="idea一定要经过自己的思考，不要人云亦云，即使是你导师给了一个新的idea，也要有自己的思考与判断。"></a>idea一定要经过自己的思考，不要人云亦云，即使是你导师给了一个新的idea，也要有自己的思考与判断。</h3><p>PPT是这次我感受最深的一部分。因为国赛准备期间，PPT是最折磨人的。起初，这种形式作为决赛我很抗拒，但是我慢慢地发现，PPT是必不可少的，毕竟，你的创意再好，也要说服众人才能得到认可。这很现实，“写代码的干不过做PPT的”，也很现实。我本身是比较会说的人，所以我基本上不打草稿，每次都是即兴发挥。</p><h3 id="不要抗拒PPT。"><a href="#不要抗拒PPT。" class="headerlink" title="不要抗拒PPT。"></a>不要抗拒PPT。</h3><p>3、虽然说是这样说，但是idea的实现一样很重要。PPT大赛的前提是你的系统已经实现，毕竟没有实现你甚至无法跻身答辩的舞台。对于第一次参加的同学，更重要的是去学习，不论是前端语言也好，数据库也罢，后端api亦然，都可以分工来学习，根据大家的兴趣点去分配。我们当时就学了一个月，做了一个很粗糙的demo。虽然现在看来，那个demo很简单很粗糙，但是当时，几个人围着电脑兴奋的像群孩子。</p><p>4、对我来说，与国二相比，最重要的收获是友情。在一次次地讨论中，和队友磨合出来的感情更加珍贵。毕竟比赛有很多，可以一起打比赛的人很少。通过这次比赛，我更加确信了我所向往的团队合作模式，也更加确信比起获奖，带领好团队的氛围是作为队长最重要的工作。</p><h2 id="Anyway-stay-hungry"><a href="#Anyway-stay-hungry" class="headerlink" title="Anyway,stay hungry."></a>Anyway,stay hungry.</h2><hr><h4 id="以下是暑假写的总结原文："><a href="#以下是暑假写的总结原文：" class="headerlink" title="以下是暑假写的总结原文："></a>以下是暑假写的总结原文：</h4><p>在2020-2021年，从大一上学期至大一下学期，我主要参加的竞赛是：全国大学生服务外包创新大赛。因为竞赛方面的重心基本上在这项比赛上，所以本次竞赛报告我也将围绕此比赛展开阐述。</p><p>一、简要介绍与大体感受</p><p>首先，先对全国大学生服务外包创新大赛（以下简称“服创”）做一下简要的介绍：</p><p>①服创是响应国家关于鼓励服务外包产业发展、加强服务外包人才培养的相关战略举措与号召，举办的每年一届的全国性竞赛。大赛的主要目的是搭建产学结合的大学生服务外包创新创业能力展示平台；促进校企交流，促进高等教育为服务经济发展提供人才保障；宣传服务经济，提升社会公众对服务外包产业发展的关注度和重视度。参赛队伍均来自中国国内高等院校，以本科生为主，自由组队。大赛开放方式竞赛，经过报名参赛、自主选题、分散备赛和集中答辩的环节，评选出相应的优秀团队。</p><p>②大赛在选题上呼应服务外包产业，关注服务科学；在形式上，注重学生的团队协作，在虚拟的商业环境中解决问题。赛题一方面来源于现代服务产业企业的现实需求，鼓励学生综合考虑业务模型、技术方案、商业运营等各种因素，提供完整方案，立足实际情况创新应用；另一方面，大赛还鼓励参赛团队提出有创造力的创意项目，在优秀方案的基础上实现创业，增强大学生的创新创业意识。在评审环节过程与结果并重，增强能力培养导向，尤其关注团队的综合素质、学习能力与问题解决能力。</p><p>以上的介绍来自服创比赛官网，从初赛走到今天的国赛，我想谈谈我自己的感受。总体来说，服创是相对其它学科竞赛来说门槛比较低的比赛，这也是为什么我会把他选做我竞赛旅程的起点站。但是门槛低意味着上限很高，就像产品经理人人能做，但是优秀的产品经理万里挑一一样。如何把一个个命题理解到位、对症下药；如何在实现需求的同时兼顾经济效益和社会效益；如何为企业的长足发展提供进一步的支持……这都在考虑的范畴之内。对于我来说，我很喜欢这种能让我进行产品设计、商业模式规划的比赛，可能骨子里，是想走产品这条路吧。比赛形式上，虽然没有很硬性的技术要求，但是代码的实现和思路的呈现都是很重要的部分。如果只是抱着逃避写代码的想法来纸上谈兵，那绝对走不到最后。</p><h3 id="我的总体感受可以总结为：好的solution-足以体现idea的实现-x3D-成功。"><a href="#我的总体感受可以总结为：好的solution-足以体现idea的实现-x3D-成功。" class="headerlink" title="我的总体感受可以总结为：好的solution + 足以体现idea的实现&#x3D;成功。"></a>我的总体感受可以总结为：好的solution + 足以体现idea的实现&#x3D;成功。</h3><p>二、关于团队与角色</p><p>我在团队中扮演的角色是：队长、统筹协调、文档、算法、答辩、美工。</p><p>没错，我的角色中并没有功能实现，因为在我们的分工之中，已经有适合的人选，并且不负责功能实现能让我更好的帮助其他人抓时间，更广泛地了解双方都在做一些什么。</p><p>我认为在服创比赛之中，最为重要的，就是一个好的团队。尤其是对于队长这个角色来说。一个优秀的团队，不是没有争端的团队，而是在矛盾发生之后能够积极消化解决的的团队。良好的沟通、轻松的氛围、共同的目标、满腔的热情，都是支撑一个团队走到最后的东西。团队中的分工一定要明确，划分不清的话就容易耽搁进度或是降低工作效率。</p><p>我很庆幸遇到我现在这个团队，更难能可贵的是，我们都是大一新生，都愿意向着眼前的不确定进发。大家相处起来也比较融洽，产生矛盾也能很有效的发现和解决。没有矛盾，是不可能的。如何解决问题、调和人际关系，是当队长的艺术。</p><p>在这次比赛的共事中，大家都感觉到了彼此的可靠，也结伴申报了大创项目，跟着导师进行学习。所以，一个优秀的团队能为你带来的不仅仅是一次比赛的胜利，更是一群志同道合的朋友、更多的机遇与选择。</p><p>三、关于时间线与节奏</p><p>服创开始报名的时间是2020年底，到现在已经过去了大半年。每年的服创比赛基本上都是在年底开始报名，在次年四月进行初赛、五月进行区域赛，最后进行全国总决赛。战线拉得很长，是折磨，也是享受。</p><p>这一路走来，我认为比较科学的时间安排应该是这样的：</p><p>①12月：组队、互相熟悉。</p><p>②次年1月：报名、选题、安排好寒假各自的工作方向。（像我们一开始什么都不会，就利用好寒假这段时间先学基础的东西）</p><p>③寒假期间：学习该学的东西、进行需求调研、进行最基本的文档的撰写。（概要介绍、需求分析、PPT等等）</p><p>④3月-4月：进行文档的编写和代码的逐步实现。（初赛不会特别看重代码的实现程度，但是不能没有）</p><p>⑤4月：初赛进行。</p><p>⑥5月-6月：做答辩PPT、模拟演练、区域赛进行。</p><p>⑦暑假：完善idea、改良PPT、完善系统、准备国赛。</p><p>磕磕碰碰，也算是走到了国赛。从零基础的小白，到现在能够写这么多的经验总结，服创让我们成长了很多。</p><p>节奏上，我们在放寒假之前就约定好至少一周要开一次会。最后也确实做到了，大家在一次次开会后的闲聊中也越来越熟悉，寒假过的也很充实。在返回学校之后，我们坚持每周周末在南校的咖啡厅聚头，一起写代码、写文档，逐渐和咖啡店有了情感。许多很棒的想法也都是在那里孕育出来的。<br>所以，定期的沟通交流是很重要的，不论是对推进工作还是改善团队氛围。第一次作为队长参加这种长时间的比赛，把握节奏和时间线的时候也是战战兢兢。好在一切顺利进行，没有出现很大的差错。</p><p>四、关于选题与idea</p><p>服创A类的选题很多样化：服务类、算法类等等，有偏idea的，也有偏实现的。前者比较注重商业价值、解决方案的可行性；后者更注重实现程度、论文的查阅量等等……我们一开始没有想太多，毕竟没有基础，选择了企业服务类的命题，主要打磨idea。</p><p>但是选完我们才意识到，这种服务类的问题难度真的很大。因为企业的具体需求存在，需要你提供解决方案，但是全国有数百支队伍都在思考这个问题的解决方案，如何让你的solution脱颖而出，是很有挑战性的事情。我们这个命题最初有接近600支队伍选择，最后到国赛的队伍不过10支，淘汰率还是很高的。毕竟服务类门槛低，队伍数量自然大。</p><p>在最开始我们讨论solution和idea的时候，基本上是毫无章法、一团乱麻。加上大家刚刚认识不久，也没有很好的表达出自己的意思。回看最初版本的系统概要介绍，其实和最终版本的差距还是很大的。所以它需要你去不断打磨想法，不断找到创新点，不断找到更优的解决方案。我的个人经验是，要想找到符合需求的解决方案，一定是从痛点入手。你找到问题的症结，你才能提出对方有可能满意的解决方案。评委感觉到你对于问题的理解和他很契合，你自然能拿到不错的成绩。所以最开始的还是，痛点分析。再根据分析结果罗列解决方案，逐一筛选。</p><p>有一个挺重要的点，是商业模式。其实企业服务类会比较注重这个内容，你怎么在解决问题的同时给企业带来收益，你怎么把自己推销出去，是很加分的点。</p><p>在起初打磨方案雏形的时候，我一直觉得我们的想法缺乏新意和竞争力，在咨询了老师和学长学姐之后，结合大家的建议慢慢讨论修改，才有了最终的结果。</p><p>四、关于具体工作</p><p>整个比赛的工作主要是三个部分：文档、实现、答辩。</p><p>前两个部分是比赛前期的重点，在初赛结束后，重点便是后二者，答辩更是重中之重。</p><p>文档部分，前前后后我们应该完成了将近六万字的文档撰写，另外制作了简介视频、演示视频。与大部分队伍选择代做不同，我们的视频从内容到配音到后期，都是我完成的制作。可以说文档方面，我们的准备很充分。</p><p><img src="http://4myblog.oss-cn-beijing.aliyuncs.com/img/111.jpg" alt="111"></p><center>（文档如上图）</center><p>实现部分，在我们队伍的“技术总监”进行安排部署之后，对应工作部分的同学就去学习相应的知识，然后真正的demo实现在寒假过后的一个月内完成。前前后后改了很多版，但是第一版出生的那种成就感，永远没有办法取代。</p><p>答辩部分，由于我个人认为我的表达能力比较强，所以路演答辩的部分就是我来负责。PPT是大家一起修改制作的，然后由我来进行思路编排。区域赛前的两个星期，简直就是地狱。每天都在根据老师、学长学姐、同学的建议思考怎么改PPT，不停地进行模拟演练。虽然我最后连稿子都没有写，但是这也是建立在私下演练了很多次的基础之上。没有稿子其实能减轻我的压力，把自己真的当作是在介绍自己设计的产品一样。</p>]]></content>
    
    
    <summary type="html">大一学年，获全国大学生服创比赛全国二等奖。</summary>


    <category term="比赛经历" scheme="http://example.com/categories/%E6%AF%94%E8%B5%9B%E7%BB%8F%E5%8E%86/"/>
    
    
    <category term="服创" scheme="http://example.com/tags/%E6%9C%8D%E5%88%9B/"/>
    
  </entry>
  
  <entry>
    <title>Blog</title>
    <link href="http://example.com/2021/09/04/Blog/"/>
    <id>http://example.com/2021/09/04/Blog/</id>
    <published>2021-09-04T15:10:47.000Z</published>
    <updated>2022-07-17T18:12:00.918Z</updated>
    
    <content type="html"><![CDATA[<p>计算机学生的第一篇个人博客，我想写写我自己。</p><h2 id="我是谁？"><a href="#我是谁？" class="headerlink" title="我是谁？"></a>我是谁？</h2><h3 id="学生"><a href="#学生" class="headerlink" title="学生"></a>学生</h3><p>十九岁生日刚刚过去，“学生”这个身份也持续了十九年。</p><p>我经常问自己，这十九年，我学到了什么？</p><h4 id="高中"><a href="#高中" class="headerlink" title="高中"></a>高中</h4><p>前十八年为了高考所学习的一切，基本上和我现在的专业没有什么关联。</p><p>但是这十八年，我学到了如何合理地统筹安排事宜，这一点我感谢为每一位学生提供硕大平台的母校，汕头金中；我学到了如何科学地学习和生活，这一点我感谢为每位学生提供同等机会的母校，汕头金中；最重要的是，我学到了怎样才是一个健全的人。</p><p>因此，我个人博客的主标题叫做“Gimdong”，以此致敬我的母校，汕头金中。</p><h4 id="大学"><a href="#大学" class="headerlink" title="大学"></a>大学</h4><p>再谈谈大学。</p><p>现在博主刚进入大二，在开学的前一天晚上敲下这篇博客。</p><p>大一的一整年，我经历了太多的心理状态：激动、失望、自我怀疑、希望。</p><h5 id="激动"><a href="#激动" class="headerlink" title="激动"></a>激动</h5><p>进入新学校，进入一个很吃香的专业，起初，我是兴奋的。虽然我没有任何计算机语言基础，但是我相信自己的学习能力。</p><p>抱着憧憬与向往，我加入了科协，想向优秀的人物靠近；我加入了合唱团，作为繁忙学习的喘息；我加入了音乐社，因为这是我所热爱的一切。</p><p>可接着，落差与失望接踵而至。</p><h5 id="失望与自我怀疑"><a href="#失望与自我怀疑" class="headerlink" title="失望与自我怀疑"></a>失望与自我怀疑</h5><p>C语言的期中考试我考得不错，可是第一次期末考试没有发挥好，考的很不理想，如果第二次机会没把握住的话，甚至有可能会挂科。</p><p>“C语言挂科。”对于自尊心比较强的我来说，是不能接受的事情。即使还没有发生。</p><p>于是我开始畏难、自我怀疑，所学课程里面当时只有C语言是和专业紧密相连的课程，所以我开始觉得自己可能真的不适合这个专业。去年的年底，负能量爆棚，甚至开始考虑要不要转专业了。</p><p>好在，希望之火依然未灭。</p><h5 id="希望"><a href="#希望" class="headerlink" title="希望"></a>希望</h5><p>过了两天我睁开眼睛。</p><p>“不行！”我对自己说。</p><p>不能就这样放弃。于是我开始不断刷题，借了同学的号，登上练习题数量多的班级的oj刷题，刷完总结经验，刷着刷着，不再那么慌了。</p><p>我开始发现，AC的那种喜悦感，令人着迷。</p><p>于是第二次考试，我把握住了机会，考得不错，并没有挂科。</p><p>而刚结束的第二学期，我的各科分数都比较高，几科90+把我送进了前50，虽然大物66狠狠地拖了我的后腿。</p><p>作为学生的我，还要继续努力。</p><h3 id="挑战者"><a href="#挑战者" class="headerlink" title="挑战者"></a>挑战者</h3><p>我是个喜欢冒险和挑战的人，未知的领域，于我总是看起来很迷人。</p><p>我想成为一个优秀的人才，这意味着有许多事情需要去尝试、去做。</p><p>去年年底，我组队参加了全国大学生服务外包创新大赛，担任队长。我们队伍都是没有比赛经验的大一学生，其实当时参加的时候，大家的心态很简单：“来玩一下就行。”</p><p>这一玩，也玩了快一年。</p><p>比完国赛，我才真正意识到，很多事情你愿意去尝试，就成功了一半。虽然这个比赛门槛不高，但是能打到这里，我心里还是很开心的，毕竟为我接下来的一步一步开了个好头。</p><p>比完我也意识到，很多比赛根本不是看起来那么玄乎其玄，绝知此事要躬行。</p><h2 id="未完待续"><a href="#未完待续" class="headerlink" title="未完待续"></a>未完待续</h2><p>还有很多可能的身份，我会慢慢补充。我希望这篇博客能够见证我一步步成为我想成为的人，见证我从迷茫到坚定、从胆怯到勇敢。</p><h1 id="There’s-still-a-long-way-to-go"><a href="#There’s-still-a-long-way-to-go" class="headerlink" title="There’s still a long way to go."></a>There’s still a long way to go.</h1>]]></content>
    
    
    <summary type="html">起点。</summary>


    <category term="Life" scheme="http://example.com/categories/Life/"/>
    
    
    <category term="自述" scheme="http://example.com/tags/%E8%87%AA%E8%BF%B0/"/>
    
  </entry>
  
</feed>